Amazon Bedrock Guardrails는 생성형 AI에 들어가는 내용과 나오는 내용에 안전 정책을 적용하는 기능입니다. 여기서 HIGH는 문맥에 따라 뜻이 달라집니다. 설정의 HIGH는 엄격한 검사 강도이고, 결과의 HIGH는 해당 유해 범주에 속한다고 분류한 높은 신뢰도입니다.
따라서 “필터를 HIGH로 설정하면 HIGH로 탐지된 내용만 막을까?”에 대한 답은 아닙니다. 차단 동작을 사용한다는 전제에서 HIGH 강도는 LOW·MEDIUM·HIGH 신뢰도로 분류된 유해 콘텐츠를 대상으로 합니다. 다만 검사 강도를 높였다고 모든 입력이 검사되거나 모든 탐지가 실제 차단으로 이어지는 것은 아닙니다. 강도, 동작, 검사 범위를 따로 읽어야 합니다. 공식 필터 강도 설명
설정과 결과를 서로 다른 질문으로 읽기
필터 강도인 inputStrength와 outputStrength는 운영자가 설정하는 값입니다. 입력과 응답에 서로 다른 강도를 정할 수 있습니다. 예를 들어 입력은 HIGH, 응답은 MEDIUM으로 구성했다면 같은 신뢰도 LOW라도 검사 방향에 따라 정책 판단이 달라질 수 있습니다. 설정 API
반면 실행 결과의 confidence는 특정 콘텐츠가 특정 범주의 유해 콘텐츠라고 분류된 정도를 나타냅니다. 동일한 문장이 여러 범주에서 다른 신뢰도를 가질 수 있으므로 “이 요청의 신뢰도는 HIGH”처럼 요청 전체를 하나의 값으로 요약하면 판단 근거를 잃습니다. 범주인 type과 함께 봐야 합니다. 아래 표는 공식 문서의 관계를 정리한 것입니다. 분류와 강도
이 표의 HIGH를 “더 높은 신뢰도만 받아들이는 보수적인 탐지”로 해석하면 방향이 반대가 됩니다. 설정을 HIGH로 높이면 낮은 유해 신뢰도까지 필터링 범위에 들어옵니다. 이것은 위험한 내용을 더 넓게 걸러내려는 선택입니다. 정상 업무 문장도 더 자주 영향을 받을 수 있으므로, 무조건 최댓값으로 정하기보다는 허용해야 할 합성 예제도 함께 검사하는 편이 좋습니다.
LOW·MEDIUM·HIGH는 API가 공개하는 분류 값입니다. 이 이름만으로 내부 확률이나 정확한 수치 경계를 추정해서는 안 됩니다. “HIGH는 90% 이상” 같은 숫자는 이 문서와 API 필드만으로 확인할 수 없습니다.
탐지되었다는 말과 차단되었다는 말
강도를 읽은 다음에는 동작을 읽습니다. 설정의 inputAction·outputAction에는 BLOCK 또는 NONE을 사용할 수 있습니다. NONE은 탐지 정보를 반환하되 해당 필터로 차단하지 않는 모드입니다. 평가를 끄는 inputEnabled·outputEnabled와도 다릅니다. 탐지 전용과 평가 비활성화를 하나로 묶으면 검사 자체가 없었던 경우를 놓칩니다. 설정 API의 action·enabled
실행 결과의 GuardrailContentFilter에는 type, confidence, action이 있고, detected와 filterStrength는 선택 필드입니다. 설정에서는 BLOCK, 결과에서는 BLOCKED라는 이름을 사용한다는 점도 구분해야 합니다. 다음 JSON은 필드의 역할을 설명하기 위해 새로 만든 합성 평가 항목이며, 실제 AWS 응답이나 탐지 성능 측정값이 아닙니다. 실행 결과 API
{
  "type": "HATE",
  "confidence": "LOW",
  "filterStrength": "HIGH",
  "detected": true,
  "action": "BLOCKED"
}
이 항목은 “분류 신뢰도는 LOW지만, HIGH 강도의 차단 정책에 해당했다”는 관계를 설명합니다. 같은 조건에서 설정 동작이 NONE이라면 신뢰도가 있다는 이유만으로 차단이라고 기록해서는 안 됩니다. 실제 처리는 서비스가 반환한 action과 호출 API의 응답을 함께 확인해야 합니다.
예를 들어 Converse에서 가드레일이 개입한 응답은 stopReason이 guardrail_intervened로 나타날 수 있습니다. 트레이스를 활성화했다면 해당 평가 정보와 함께 원인을 확인합니다. 한 필터 항목의 action: NONE만 보고 요청 전체가 허용되었다고 결론 내려서도 안 됩니다. 다른 정책이 개입했을 가능성이 있기 때문입니다. Converse 응답 처리
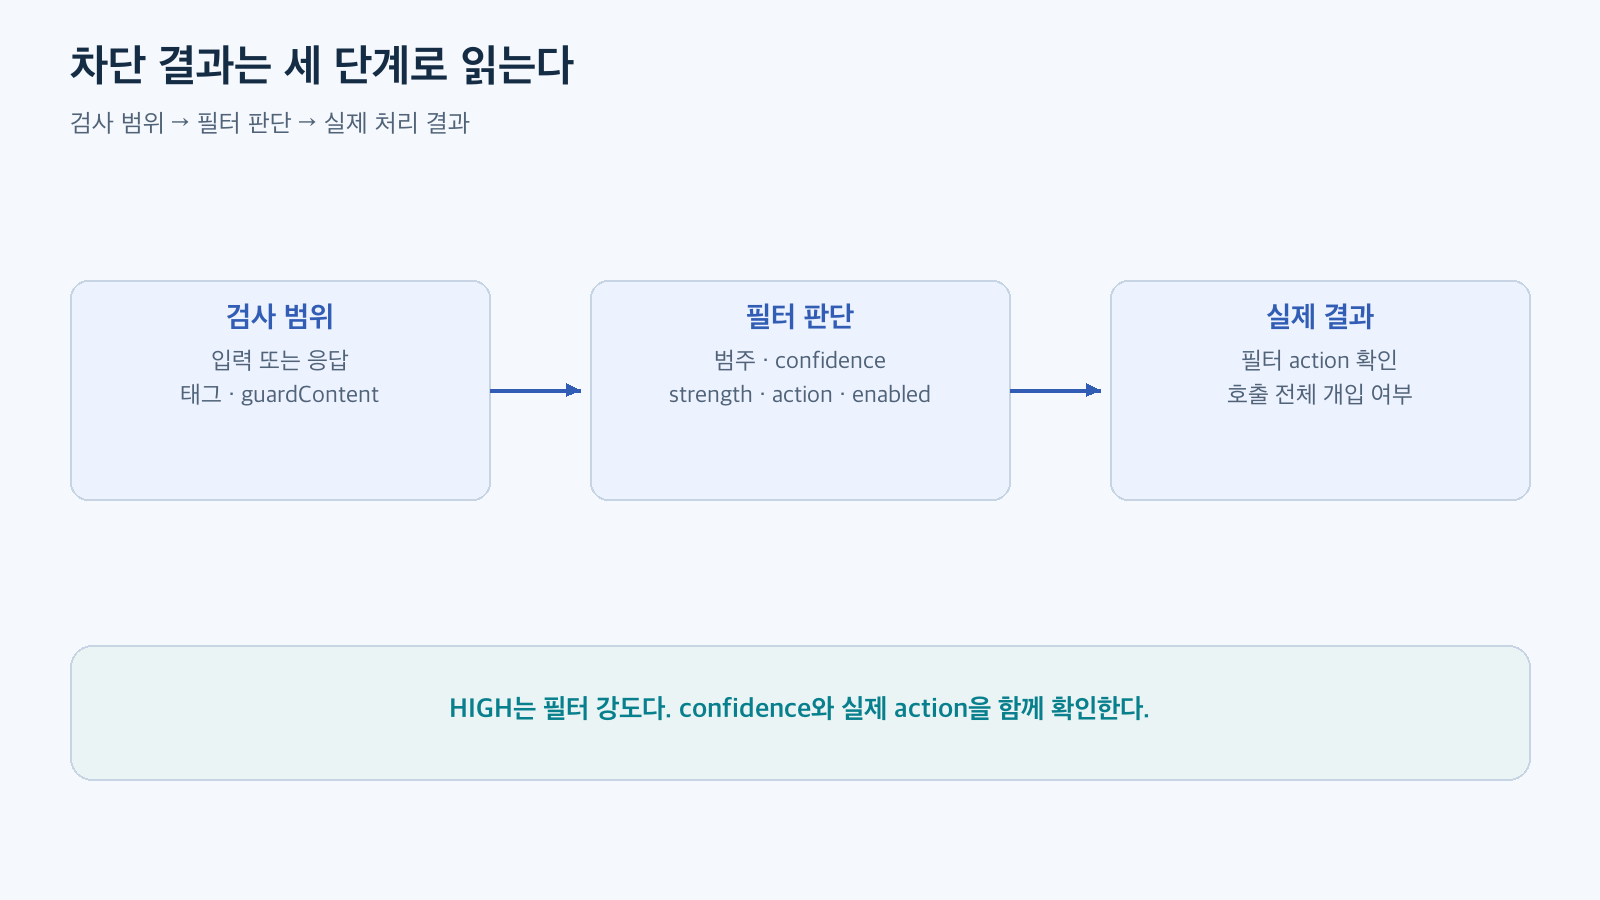
그림: 검사 범위 → 필터 판단 → 실제 처리 결과 · 공식 문서를 바탕으로 재구성
HIGH보다 먼저 확인해야 할 검사 범위
PROMPT_ATTACK은 개발자의 지시를 바꾸거나 안전 장치를 우회하려는 입력을 검사하는 필터입니다. 프롬프트 공격 설정은 inputStrength·inputAction을 기준으로 읽습니다. 일반 유해 콘텐츠 범주의 입출력 검사와 동일한 적용 범위로 가정하거나, 응답에 붙일 일반 유해 콘텐츠 정책을 대신한다고 보아서는 안 됩니다.
특히 InvokeModel과 InvokeModelWithResponseStream을 사용할 때는 사용자 입력을 가드레일 입력 태그로 표시해야 프롬프트 공격 필터가 그 부분을 검사합니다. 이 경로에서 태그가 없으면 PROMPT_ATTACK은 검사되지 않습니다. 개발자 지시문을 사용자 공격 입력과 혼동하지 않도록 범위를 구분하는 장치입니다. 또한 공식 문서는 프롬프트 공격 필터가 toolResult와 toolSpec을 평가하지 않는다고 명시합니다. “Guardrails를 붙였다”는 사실만으로 도구 결과까지 검사되었다고 기록할 수 없습니다. 프롬프트 공격 필터
입력 태그의 모양은 다음과 같습니다. 이것도 실제 요청이 아닌 가상 입력 구조입니다.
개발자 지시: 공개 문서의 내용을 설명한다.
<amazon-bedrock-guardrails-guardContent_demoA1>
가상 문서의 요점을 알려 주세요.
</amazon-bedrock-guardrails-guardContent_demoA1>
실제 요청 본문에서는 amazon-bedrock-guardrailConfig.tagSuffix도 태그의 접미사와 맞춰야 합니다. 예제의 demoA1은 설명용 고정값이며 운영에서는 요청마다 예측하기 어려운 새 접미사를 사용하라는 공식 권고를 따릅니다. 태그를 사용하면 태그 밖의 내용은 검사 범위에서 빠집니다. 태그를 전혀 사용하지 않으면 일반 가드레일은 전체 입력을 처리하지만, 앞에서 설명한 PROMPT_ATTACK은 예외입니다. 입력 태그 사용 규칙
Converse에는 이 XML 태그를 그대로 가져가지 않습니다. 가드레일 연결은 guardrailConfig로 하고, 검사할 메시지 일부를 선택할 때는 guardContent 블록을 사용합니다. 시스템 메시지의 검사 여부도 메시지 본문의 검사 여부와 따로 확인해야 합니다. 이 글의 예제는 contextual grounding 등의 qualifiers 설정을 다루지 않습니다. 검사 범위를 바꾸는 다른 정책을 함께 사용하는 경우에는 해당 정책 문서도 확인해야 합니다. Converse 검사 범위
정책표를 로컬 회귀 테스트로 고정하기
문서의 표를 코드에 옮겨 놓으면 설정 해석이 뒤집히는 실수를 쉽게 잡을 수 있습니다. 다음 예제는 AWS에 연결하지 않습니다. 이미 분류된 합성 신뢰도와 설정의 관계만 검사하며, 실제 문장의 유해성을 판정하는 탐지기가 아닙니다.
import unittest

BLOCKED_CONFIDENCES = {
    "NONE": set(),
    "LOW": {"HIGH"},
    "MEDIUM": {"MEDIUM", "HIGH"},
    "HIGH": {"LOW", "MEDIUM", "HIGH"},
}

def policy_action(strength, confidence, configured_action="BLOCK"):
    # 이미 분류된 값에 정책표를 적용한다. AWS 탐지 모델을 재현하지 않는다.
    if strength not in BLOCKED_CONFIDENCES:
        raise ValueError("알 수 없는 강도")
    if confidence not in {"NONE", "LOW", "MEDIUM", "HIGH"}:
        raise ValueError("알 수 없는 신뢰도")
    if configured_action not in {"BLOCK", "NONE"}:
        raise ValueError("알 수 없는 설정 동작")
    if configured_action == "NONE":
        return "NONE"
    return "BLOCKED" if confidence in BLOCKED_CONFIDENCES[strength] else "NONE"

class FilterMatrixTests(unittest.TestCase):
    def test_all_sixteen_pairs(self):
        # 각 행은 신뢰도 NONE, LOW, MEDIUM, HIGH 순서다.
        expected = {
            "NONE": ["NONE", "NONE", "NONE", "NONE"],
            "LOW": ["NONE", "NONE", "NONE", "BLOCKED"],
            "MEDIUM": ["NONE", "NONE", "BLOCKED", "BLOCKED"],
            "HIGH": ["NONE", "BLOCKED", "BLOCKED", "BLOCKED"],
        }
        for strength, actions in expected.items():
            for confidence, action in zip(("NONE", "LOW", "MEDIUM", "HIGH"), actions):
                with self.subTest(strength=strength, confidence=confidence):
                    self.assertEqual(policy_action(strength, confidence), action)

    def test_detect_only_does_not_block(self):
        self.assertEqual(policy_action("HIGH", "HIGH", "NONE"), "NONE")

    def test_invalid_value_is_not_silently_allowed(self):
        with self.assertRaises(ValueError):
            policy_action("HIGH", "UNKNOWN")

if __name__ == "__main__":
    unittest.main()
test_filter_matrix.py로 저장한 뒤 python3 test_filter_matrix.py를 실행합니다. 이 글을 준비하면서 세 테스트와 16개 강도·신뢰도 조합을 로컬에서 확인했습니다. 결과는 Ran 3 tests와 OK였습니다. AWS API 호출, 실제 분류 결과, 유료 평가의 성공을 뜻하지 않습니다.
이 테스트를 애플리케이션에 연결한다면 서비스 응답 해석 코드와 문서의 정책표를 구분해 유지합니다. 응답에 없는 신뢰도를 추측하거나, 로컬 계산 결과를 실제 가드레일의 action 대신 저장해서는 안 됩니다.
운영에서 읽어야 할 순서
설정이 원하는 결과를 내지 않을 때는 다음 순서로 확인합니다.
- 실제 호출이 연결한 가드레일과 버전이 의도한 것인지 확인합니다.
- 해당 범주와 입력/응답 방향의 strength·action·enabled 설정을 확인합니다.
- 호출 API에 맞는 태그 또는 guardContent 범위를 확인합니다.
- 실제 평가 항목의 type·confidence·action과 호출 전체의 처리 결과를 확인합니다.
- 정상 합성 예제와 정책 위반 합성 예제를 분리해 설정 변경 전후를 비교합니다.
HIGH는 강도 설정에서 더 넓은 유해 신뢰도 범위를 필터링한다는 뜻입니다. 최종적인 서비스 안전성은 강도 하나가 아니라 무엇을 검사했는지, 어떤 동작으로 처리했는지, 애플리케이션이 결과를 어떻게 사용했는지까지 확인해야 판단할 수 있습니다.
'일반IT > AI' 카테고리의 다른 글
| ChatGPT dot 종합 가이드: 지속적 업무 위임·음성·연결 앱·사용자 통제 (0) | 2026.10.05 |
|---|---|
| GPT‑6.1 Sol로 바꿔야 할까? 6 Sol·Astra와 비교할 기준 (0) | 2026.10.04 |
| 하네스와 가드레일, 무엇이 다를까? AI 에이전트의 실행과 통제 (0) | 2026.10.01 |
| ChatGPT Pro 200 사용량 절반 축소, 무엇이 달라지나? (0) | 2026.09.30 |
| LLM vs Jev, 무엇을 맡겨야 할까? 생성·판단·비용으로 비교하기 (0) | 2026.09.28 |


