ChatGPT Pro 200은 월 200달러인 개인 구독 요금제다. 이번 변경의 핵심은 가격을 유지하면서 ChatGPT Work와 Codex에 포함되는 사용량의 상대 배수를 Plus의 20배에서 10배로 낮추는 것이다. 기존 한도를 유지할 자격이 있는 가입자는 2026년 10월 29일까지 이전 한도를 쓰고, 이후 새 한도로 전환된다. OpenAI Pro 도움말 · 담당자의 배수 설명
따라서 “Pro 200의 기본 사용량이 절반으로 줄어든다”는 설명에는 근거가 있다. 다만 여기서 절반은 요금제의 상대적인 사용 한도다. 실제로 끝낼 수 있는 개발 작업 수, GPT-6 Pro의 채팅 횟수, 추가 크레딧 잔액은 각각 다른 기준으로 읽어야 한다.
이 글은 2026년 9월 30일 기준으로 공식 도움말·문서·담당자 발표를 대조했다. 보상 크레딧과 일부 세부 수치는 공개된 수신 메일 전재본까지 확인하되, 공식 사이트에서 직접 검증한 내용과 구분했다. 중요한 차이는 보상의 사용처, Ultrafast의 소모율, dot이 다른 제품에 맡기는 작업의 차감 방식에 있다.
1. 어디까지 확인됐나: 공식 문서와 메일 안내를 나눠 보기
OpenAI 도움말에는 Pro 200이 낮아진 사용 한도로 신규 가입을 다시 받으며, 대상 기존 가입자는 10월 29일까지 이전 한도를 유지한다는 내용이 있다. Codex·ChatGPT 담당자인 Thibault Sottiaux의 발표에는 기존 20배와 새 10배가 직접 등장한다. 공식 도움말 · 발표 원문
반면 62,500 크레딧, 12월 31일 만료, GPT-6 Pro 주 200회에서 100회로 변경하는 문구는 이번에 열람한 공개 도움말에 모두 기재돼 있지는 않았다. 이 수치들은 수신자가 공개한 메일 전재본에서 확인됐다. 전재본은 공식 사이트에 게시된 공지와 같은 수준의 인증 자료는 아니며, 발신 메일의 원본 헤더까지 검증한 것은 아니다. 공개된 수신 메일 전재본
메일 내용의 큰 방향은 공식 발표와 일치한다. 다만 지급 크레딧이 이미 모든 계정에 반영됐다고 단정하거나, 신규 가입자도 같은 보상을 받는다고 확대해서 설명할 근거는 없다.
2. 10월 30일은 누구에게 적용되나
신규 가입과 기존 가입자의 유예 기간을 나눠 보면 일정이 명확해진다. 신규 Pro 200은 낮아진 한도로 제공되고, 이전 한도를 유지할 자격이 있는 기존 가입자는 한시적으로 유예받는 구조다.
공식 도움말은 자격 판정 시점에 Pro 200이 활성 상태였거나, 그보다 앞선 7일 안에 활성 상태였던 가입자를 설명한다. 해당 기간에 구독이 만료된 경우에는 재구독 조건도 명시한다. 유예는 Pro 200 구독을 유지하는 조건이며 Pro 500이나 Ultrafast를 자동으로 제공하지 않는다. 공개 도움말에 자격 판정의 정확한 시각은 제시돼 있지 않다. 기존 가입자 적용 조건
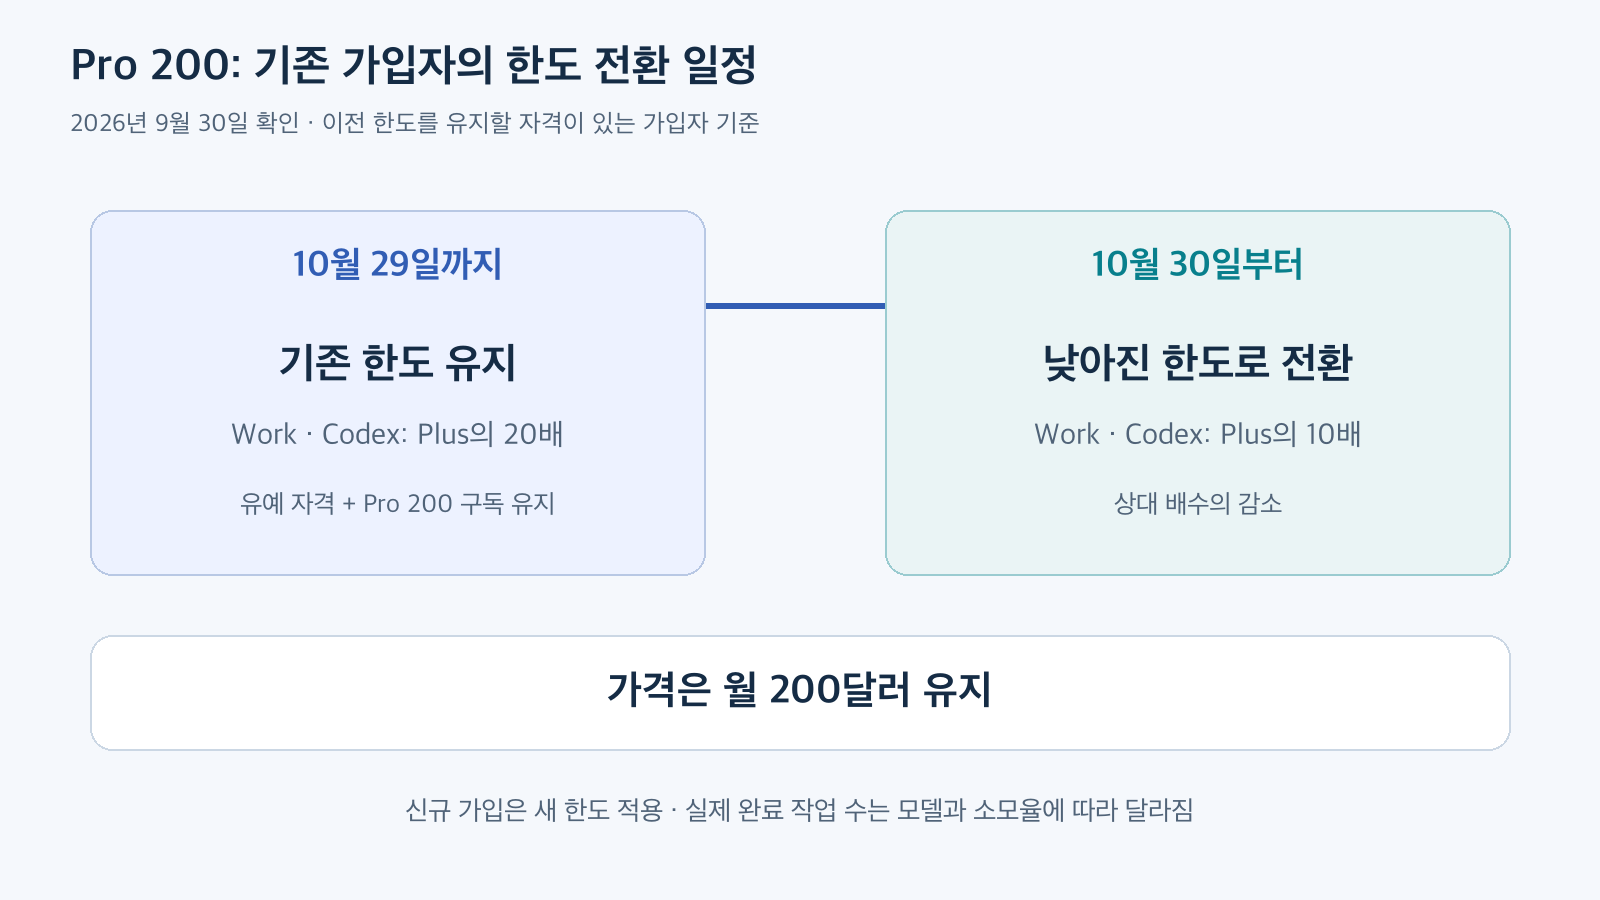
그림 1. 기존 가입자의 유예 기간과 전환 일정. Pro 도움말과 담당자의 배수 발표를 바탕으로 재구성. 공식 문서의 10월 29일 유예 종료 다음 날을 전환일로 표시했다.
예를 들어 이전부터 Pro 200을 사용하던 대상 가입자와 지금 새로 가입하는 사람이 같은 가격을 지불해도, 유예 기간에는 포함 사용량이 다를 수 있다. 그래서 변경 내용을 설명할 때는 “모든 Pro 200이 지금 즉시 절반으로 바뀐다”보다 “기존 대상 가입자의 유예 종료 후 상대 배수가 20배에서 10배로 바뀐다”가 정확하다.
Pro는 요금제 이름이면서 채팅의 고급 추론 옵션을 가리키는 표현에도 쓰인다. 이 때문에 “Pro 사용량”이라는 말만으로는 어느 한도를 뜻하는지 알기 어렵다. GPT-6 Pro의 채팅 한도와 Work·Codex의 작업 한도는 공식 도움말에서도 구분한다. GPT-6 Pro 한도 설명
3. 한도가 절반이면 끝낼 수 있는 작업도 절반일까
한도의 감소와 작업 처리량의 감소는 같은 수치가 아닐 수 있다. 담당자 발표는 새 Pro 200의 사용량을 API 지출 가치로 환산하면 이전의 절반에 해당한다고 설명하면서, 모델의 효율과 가격 개선을 구독 가치에 반영하겠다고 밝혔다. 이는 변경의 근거를 설명하는 공급자의 입장이다. 담당자 설명 원문
실제 작업에서는 모델, 추론 강도, 입력 문맥, 도구 호출, 다시 시도한 횟수가 소모량에 영향을 준다. OpenAI도 Work와 Codex의 사용량을 작업의 크기와 복잡도에 따라 계산한다고 설명한다. 같은 “버그를 고쳐줘”라는 요청이라도 작은 함수 하나를 수정하는 일과 여러 서비스의 테스트를 반복하는 일은 다른 양을 쓴다. Work·Codex 가격·사용량 문서
차이를 이해하기 위한 가상의 계산을 해 보자. 실제 요금제의 크레딧 수치를 나타내는 예시는 아니다.
핵심은 세 번째 줄이 자동으로 성립하지 않는다는 것이다. 새 모델이 같은 품질의 결과를 더 적은 재시도로 완성하면 감소분을 일부 상쇄할 수 있다. 반대로 같은 모델·설정·소모율로 일한다면 낮아진 예산만큼 여유가 줄어든다.
GPT-6.1 Sol은 공식 안내에서 Astra에 가까운 성능을 더 낮은 비용으로 제공하는 모델로 소개된다. Work와 Codex에서 제공되며, 현재 일반 채팅의 GPT-6 Pro와는 별도 모델 옵션이다. 이 설명은 모델 선택의 근거가 될 수 있지만 모든 코드베이스에서 작업당 비용이 특정 비율로 줄어든다는 실측 결과는 아니다. 출시 안내 · 모델 제공 범위
비교할 때는 같은 저장소의 유사한 작업을 골라 성공 여부, 테스트 결과, 걸린 시간과 실제 사용량을 함께 기록하는 편이 낫다. 요청 횟수만 세면 긴 작업 하나와 짧은 작업 하나가 같은 한 건으로 보이기 때문이다.
4. 62,500 크레딧은 어디에 쓸 수 있나
공개된 메일 전재본에는 기존 가입자에게 62,500 usage credits를 일회성으로 지급하며, 표시 가치는 2,500달러이고, 2026년 12월 31일 만료라고 적혀 있다. Settings → Usage에서 확인하도록 안내한다. 여기까지는 공개된 수신 안내의 내용이다. 개별 계정의 지급 완료 여부나 예외 조건까지 이 글에서 확인한 것은 아니다. 메일 전재본
그 크레딧을 해석하는 기준은 공식 개인용 크레딧 도움말에서 확인할 수 있다. 기본 포함량을 먼저 사용하고, 한도에 도달한 뒤 지원되는 기능에서 크레딧 잔액을 사용하는 방식이다. Codex, ChatGPT Work, Word, Excel, PowerPoint 등이 지원 대상이며 계정과 요금제에 따라 이용 범위가 달라질 수 있다. 이 사용량 크레딧은 API 크레딧이 아니다. 개인용 크레딧 공식 안내
따라서 다음 세 가지를 구분해서 계산해야 한다.
- 구독에 포함된 한도: 갱신 주기에 따라 사용할 수 있는 기본분이다.
- 추가 사용량 크레딧: 지원 기능에서 기본 한도를 다 쓴 뒤 이어서 쓰는 잔액이다.
- OpenAI API 과금: API 키로 호출하는 별도 청구 체계다.
크레딧이 있다고 GPT-6 Pro 채팅의 주간 메시지 한도가 자동으로 늘어난다고 볼 수는 없다. API 결제 잔액이나 월 구독료를 대신 내는 금액으로 계산할 근거도 없다. 공식 도움말은 usage credits와 달러 단위의 ChatGPT wallet도 구분한다. 크레딧과 지갑의 차이
만료일도 확인할 지점이다. 일반 구매 크레딧 도움말에는 구매 후 12개월 유효라고 안내하지만, 이번 메일 전재본에는 별도로 12월 31일이라는 기한이 제시돼 있다. 구매 크레딧의 일반 규칙을 일회성 지급분에 그대로 적용해서 만료일을 늘려 계산하면 안 된다.
이 보상의 실질적 가치는 남은 기간에 수행할 지원 작업과 그 소모율에 달려 있다. 2,500달러를 월 200달러로 나눠 “구독 12.5개월분”이라고 해석하면 서로 다른 과금 구조를 섞게 된다. 장기 비용을 판단할 때는 일회성 지급분을 소진한 뒤의 기본 한도도 함께 살펴볼 필요가 있다.
5. Pro 500과 Ultrafast: 사용량과 속도를 따로 비교하기
Pro 500은 공식 도움말에 월 500달러 요금제로 안내돼 있고, Astra Ultrafast를 포함한다. Plus 대비 25배라는 사용량 수치는 공개 메일 전재본에서 확인된다. Pro 200의 새 10배와 단순 비교하면 상대 한도는 2.5배이며 달러 기준 월 가격도 2.5배다. 이 계산은 다른 기능의 가치를 제외한 배수 비교다. Pro 요금제 도움말 · 메일의 Pro 500 안내
Ultrafast는 별도의 비교가 필요하다. 공식 속도 문서가 말하는 최대 8배는 Codex에서 GPT-6 Astra의 Standard 대비 토큰을 생성하는 속도다. 저장소를 읽고 테스트를 실행하고 외부 도구를 기다리는 시간까지 모두 8배 빨라진다는 뜻은 아니다. Ultrafast 공식 문서
Standard를 기준으로 한 소모 배수. 생성 속도 배수와 다른 지표다. 공식 가격 문서 기준.
예를 들어 모델이 답을 생성하는 시간보다 테스트 대기 시간이 긴 작업이라면 생성 가속만으로 줄어드는 전체 시간은 제한적이다. 반면 긴 답변을 기다리는 시간이 업무를 막고 있다면 가속의 가치가 커질 수 있다. 이 역시 개별 업무의 시간 구성을 보고 판단할 문제다.
Pro 500의 넓은 한도와 Ultrafast의 높은 소모율은 동시에 적용될 수 있다. 높은 요금제를 골랐다는 이유만으로 언제나 더 많은 작업을 끝낸다고 계산하기보다, 어떤 모델을 어떤 속도로 얼마나 사용할지 함께 비교하는 편이 정확하다.
6. dot은 무엇까지 사용량에서 빠지나
dot은 GPT-6 Astra 기반의 상시 실행 에이전트다. 자체 클라우드 컴퓨터와 브라우저를 가지고 장시간 작업할 수 있다. 공식 안내상 Pro에 포함되지만 지역·연령·점진적 출시 조건이 있으므로 모든 계정에 동시에 나타나는 것은 아니다. Meet dots
사용량 설명에서 가장 중요한 경계는 dot과의 대화와 dot이 Work·Codex에 시작하거나 맡겨 관리하는 작업이다. 공식 문서는 dot과의 대화는 ChatGPT 사용 한도에 포함하지 않지만, dot이 시작하거나 관리하는 Work·Codex 작업은 각 제품의 사용량에서 평소처럼 차감한다고 명시한다. 깊이 있는 작업에는 별도의 포함 한도가 있다는 설명도 있다. 따라서 “dot으로 시키면 Codex를 한도 없이 쓴다”는 해석은 성립하지 않는다. dot의 사용량 규칙
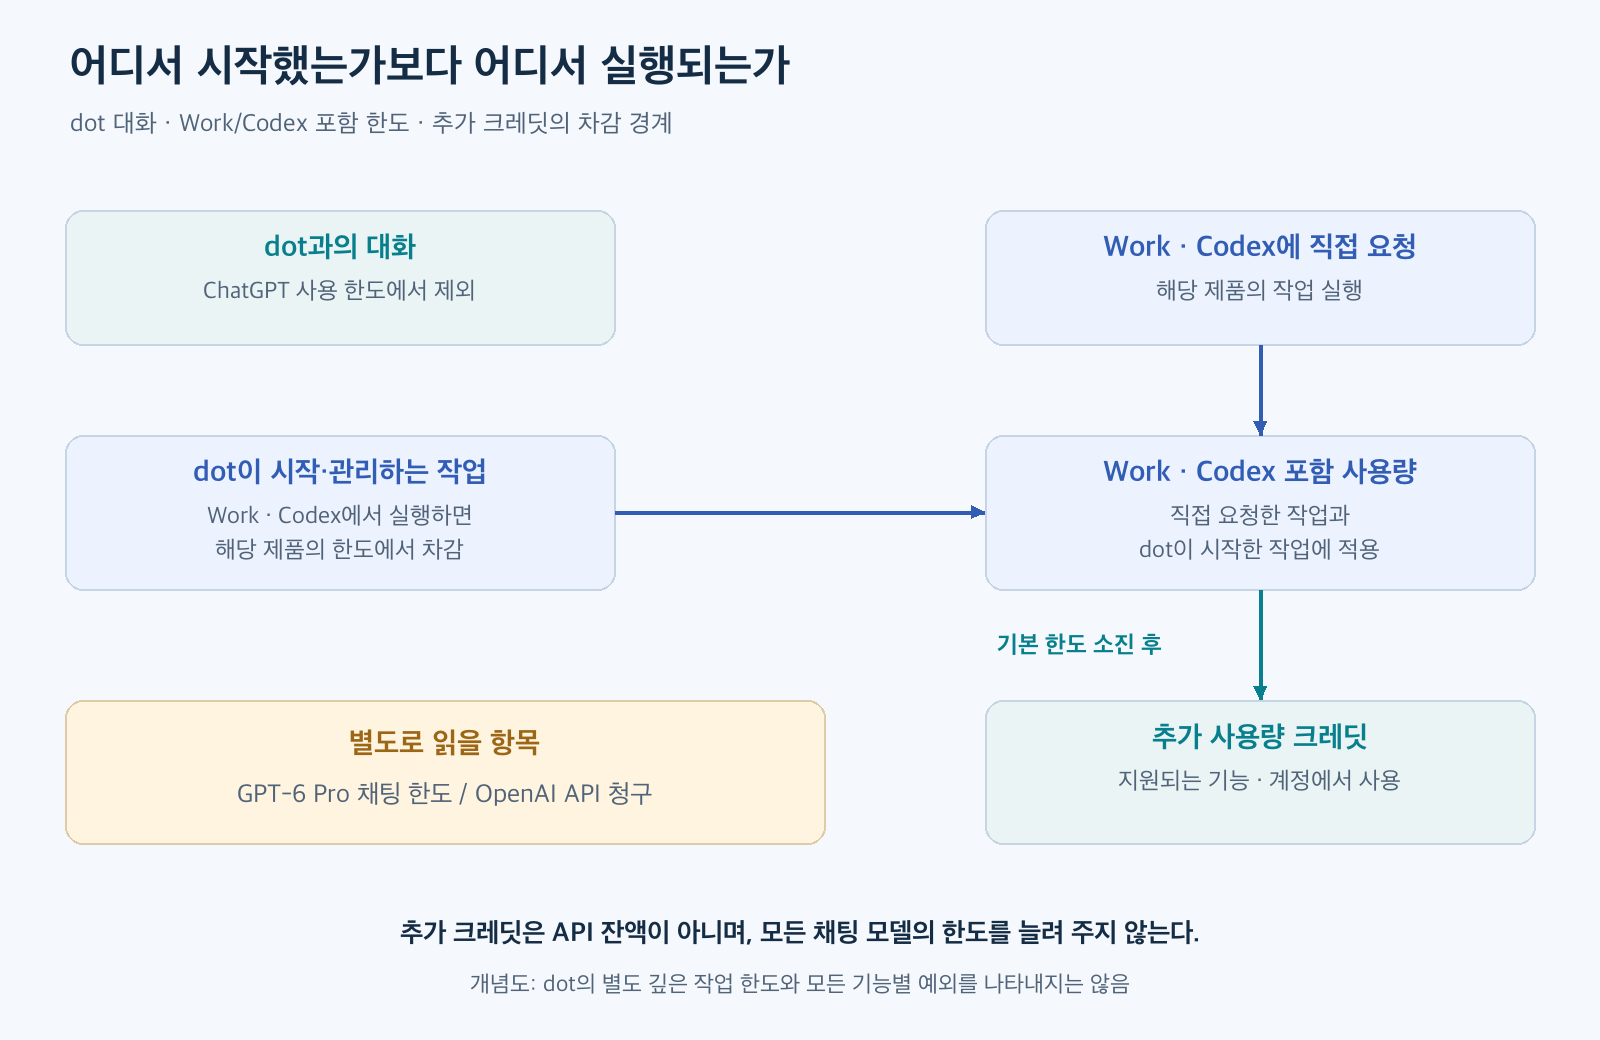
그림 2. 요청을 시작한 곳과 사용량을 계산하는 곳을 구분한 개념도. dots, Work·Codex 가격, 개인용 크레딧 공식 문서를 바탕으로 재구성. dot의 모든 세부 기능을 나타낸 그림은 아니다.
예를 들어 dot에게 진행 상황을 묻는 대화와, dot이 Codex에 저장소 분석·수정 작업을 시작시키는 것은 차감 기준이 다르다. 실제 개발 예산을 계산할 때는 에이전트의 이름보다 어느 제품에서 작업이 실행되는가를 확인하면 이해하기 쉽다.
7. Codex를 많이 쓴다면 무엇을 기준으로 결정할까
이번 변경을 평가하려면 현재 작업을 세 부류로 나누는 것이 도움이 된다. 첫째는 낮은 비용의 모델로도 충분히 끝나는 반복 작업, 둘째는 Astra의 깊은 추론이 필요한 작업, 셋째는 빠른 생성에 추가 사용량을 지불할 만큼 시간이 중요한 작업이다. 세 부류의 비중에 따라 같은 한도 변경의 영향이 달라진다.
의사결정에 필요한 기록은 복잡하지 않다. 일주일 동안 사용한 모델·속도 모드, 한도에 도달한 시점, 추가 크레딧 사용량, 완료한 주요 작업을 함께 적으면 된다. 단순 요청 수보다 완료한 작업당 소모와 대기 시간을 보는 방식이다. 잔액과 한도는 Codex 사용량 화면에서 확인할 수 있다.
한편 5시간 제한을 다시 도입하지 않겠다는 약속은 주간분을 원하는 때에 집중해 쓸 수 있다는 의미다. 주간 한도가 사라지거나 크레딧이 무제한 지급된다는 의미는 아니다. 담당자의 발표와 현재 가격 문서 모두 이 차이를 읽을 근거가 된다. 담당자 발표 · 현재 사용량 문서
정리하면, Pro 200의 20배에서 10배로의 변경과 기존 가입자의 유예 종료는 공식 근거가 있다. 보상 크레딧의 정확한 수량·만료와 채팅 주간 횟수는 공개 메일 전재본에 명시돼 있지만 계정별 지급까지 확인한 사실은 아니다. Ultrafast는 생성 속도와 소모율을 함께 봐야 하고, dot이 실행하는 Work·Codex 작업도 해당 한도를 사용한다.
요금제 선택의 기준은 변경 후 기본 한도로 실제 업무를 얼마나 끝낼 수 있는지다. 일회성 보상, 모델 효율, 속도 옵션을 각각 계산하면 구독을 유지할지, 추가 크레딧을 사용할지, 상위 요금제를 선택할지 비교하기 쉬워진다.
'일반IT > AI' 카테고리의 다른 글
| AWS Bedrock Guardrails의 HIGH, 정확히 무엇을 뜻할까? (0) | 2026.10.04 |
|---|---|
| 하네스와 가드레일, 무엇이 다를까? AI 에이전트의 실행과 통제 (0) | 2026.10.01 |
| LLM vs Jev, 무엇을 맡겨야 할까? 생성·판단·비용으로 비교하기 (0) | 2026.09.28 |
| LLM 시스템 아키텍처: 프론트엔드부터 RAG·에이전트·공급망까지 (0) | 2026.09.28 |
| LLM 시스템에 옵저버빌리티가 필요한 이유: 정상 응답 뒤에 숨은 품질·지연·비용을 추적하기 (0) | 2026.09.15 |


