LLM과 분석 시스템에 들어가는 데이터에는 이름, 전화번호, 이메일, 계좌번호와 IP 주소 같은 개인정보가 섞이기 쉽다. “모델에게 개인정보를 출력하지 말라”고 지시해도 이미 원문이 외부 모델이나 로그로 전송된 뒤라면 늦다.
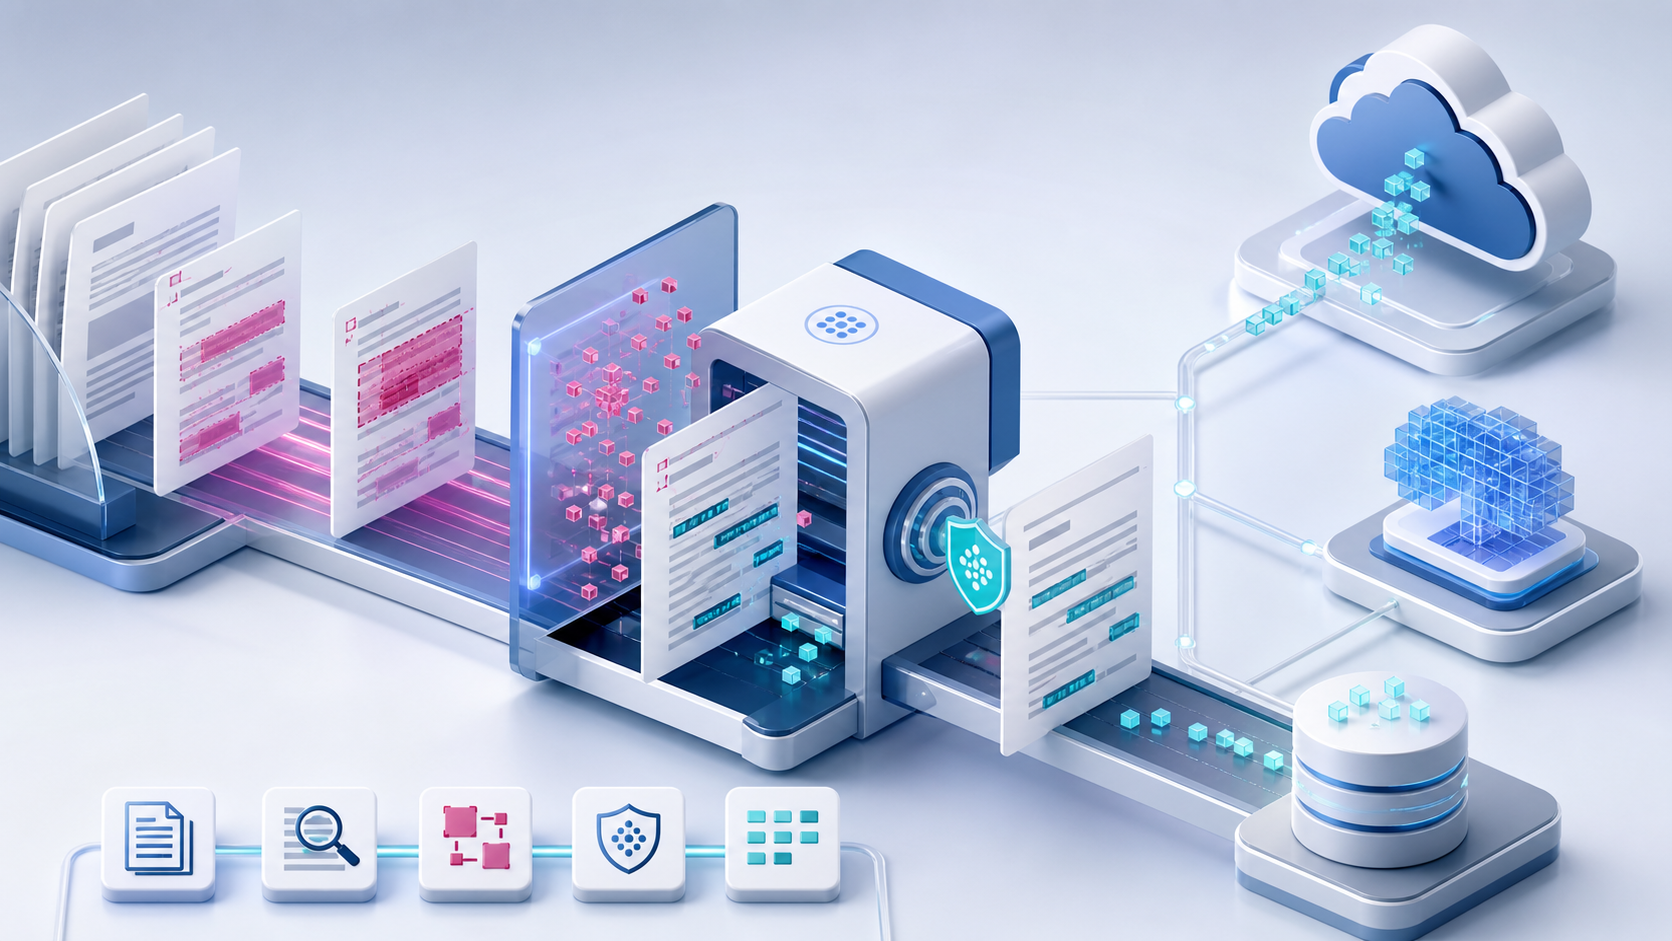
Microsoft Presidio는 텍스트·이미지·구조화 데이터에서 개인식별정보(PII)를 찾아 비식별화하는 오픈소스 도구 모음이다. 핵심은 Analyzer가 개인정보 후보와 위치를 찾고, Anonymizer가 그 위치를 마스킹·삭제·치환·암호화한다는 책임 분리다.
이 글에서는 Presidio가 무엇인지, 정규식 필터와 무엇이 다른지, Analyzer와 Anonymizer가 어떻게 협력하는지, LLM·RAG 파이프라인 어디에 놓아야 하는지와 한계를 집중적으로 살펴본다.
Presidio를 한 문장으로 설명하면
Presidio는 데이터 전체를 오케스트레이션하는 플랫폼이 아니라, 애플리케이션이 호출할 수 있는 PII 탐지·비식별화 엔진이다.
원문
  → Presidio Analyzer: 엔터티 종류·위치·점수 탐지
  → 정책 결정: 무엇을 어떻게 처리할지 선택
  → Presidio Anonymizer: 마스킹·삭제·치환·해시·암호화
  → 비식별화된 데이터
Python 라이브러리로 애플리케이션 안에 넣을 수도 있고, Analyzer와 Anonymizer를 HTTP 서비스나 컨테이너로 실행할 수도 있다. Microsoft에서 시작된 프로젝트지만 현재 공식 문서와 컨테이너 배포 경로는 Data Privacy Stack으로 이동하고 있으므로 오래된 MCR 이미지나 예전 문서 링크를 그대로 사용하지 않는 것이 좋다.
왜 정규식 몇 개로 끝나지 않는가
이메일이나 카드번호처럼 형식이 뚜렷한 값은 정규식으로 찾을 수 있다. 그러나 사람 이름, 지역, 조직명처럼 문맥에 따라 의미가 달라지는 값은 패턴만으로 판단하기 어렵다. 숫자열도 전화번호, 주문번호, 날짜 또는 단순 수량일 수 있다.
Presidio Analyzer는 여러 EntityRecognizer를 동시에 실행한다. 공식 문서는 정규식, Named Entity Recognition(NER), 체크섬, 문맥 단어와 사용자 정의 로직을 조합할 수 있다고 설명한다. 각 결과는 보통 엔터티 종류, 시작·끝 위치와 신뢰 점수로 표현된다.
from presidio_analyzer import AnalyzerEngine

analyzer = AnalyzerEngine()
results = analyzer.analyze(
    text="연락처는 010-1234-5678입니다.",
    language="ko"
)
이 예제가 한국어에서 즉시 원하는 결과를 낸다고 가정하면 안 된다. 언어별 NLP 모델과 Recognizer 지원 상태를 확인하고, 국내 전화번호·주민등록번호·사업자번호 같은 조직별 엔터티는 사용자 정의 Recognizer와 테스트 데이터로 보강해야 한다.
핵심 구성 요소
| 구성 요소 | 역할 | 실무에서 결정할 것 |
| AnalyzerEngine | Recognizer와 NLP 엔진을 조정해 PII 후보 탐지 | 언어, 대상 엔터티, 점수 임계값 |
| EntityRecognizer | 특정 PII 유형을 찾는 탐지기 | 정규식·NER·외부 모델·사용자 정의 로직 |
| RecognizerRegistry | 사용할 Recognizer 목록 관리 | 국가·업무별 활성화 범위 |
| NlpEngine | 토큰화·NER 등 언어 처리 | spaCy, Transformers, Stanza와 모델 |
| Context Aware Enhancer | 주변 단어로 탐지 점수 보강 | 문맥 단어와 오탐 조정 |
| AnonymizerEngine | 탐지 위치에 변환 연산 적용 | 엔터티별 비식별화 정책 |
| Operator | replace·redact·mask·hash·encrypt 등 실행 | 가역성, 재식별 위험, 키·Salt 관리 |
Presidio는 “어떤 정보가 개인정보인가”를 조직 대신 결정해 주지 않는다. 탐지 가능한 엔터티와 실제 규제·계약상 보호 대상은 다를 수 있으므로 정책 계층에서 별도로 매핑해야 한다.
Analyzer는 무엇을 반환하는가
Analyzer는 원문을 바꾸지 않고 후보 구간을 반환한다. 예를 들어 문자열의 10번째부터 23번째까지가 PHONE_NUMBER, 신뢰 점수는 0.85라는 식이다. 이 분리 덕분에 애플리케이션은 같은 탐지 결과를 가지고 서로 다른 정책을 적용할 수 있다.
- 로그에는 완전히 삭제한다.
- 상담 화면에는 마지막 네 자리만 남긴다.
- 통계 분석에는 동일인을 연결할 수 있는 가명값으로 치환한다.
- 권한 있는 업무 처리에는 암호화하고 별도 키로 복원한다.
점수는 사실 여부를 보장하는 확률이 아니다. 임계값을 높이면 오탐은 줄지만 미탐이 늘 수 있고, 낮추면 더 많이 잡는 대신 정상 데이터가 가려질 수 있다.
Anonymizer는 어떻게 데이터를 바꾸는가
Presidio Anonymizer는 Analyzer의 구간 정보를 받아 Operator를 적용한다. 공식 문서에는 replace, redact, mask, hash, encrypt, custom, keep 등의 연산이 설명되어 있다.
| Operator | 결과 | 적합한 경우 | 주의점 |
| replace | <PHONE_NUMBER> 같은 값으로 치환 | LLM 프롬프트·로그 | 원래 값 복원 불가 |
| redact | 해당 문자열 삭제 | 외부 공유·최소수집 | 문맥이 깨질 수 있음 |
| mask | 일부 문자를 * 등으로 변경 | 상담 화면·확인 UI | 남은 문자로 재식별 가능 |
| hash | Salt를 이용한 해시 | 통계 연결·중복 분석 | Salt 관리와 사전대입 공격 고려 |
| encrypt | 키로 암호화 | 승인된 재식별이 필요한 업무 | 키를 본문·프롬프트와 분리해야 함 |
| custom | 사용자 함수로 치환 | 가명 생성·업무 규칙 | 함수의 보안과 결정성 검증 필요 |
최신 문서는 해시 연산이 기본적으로 엔터티마다 임의 Salt를 사용한다고 설명한다. 여러 레코드에서 동일한 개인정보를 동일한 해시로 연결하려면 일관된 Salt를 직접 제공해야 하지만, 그 Salt가 유출되면 재식별 위험이 커진다. Salt와 암호화 키는 프롬프트나 일반 설정 파일이 아니라 KMS·Key Vault·Secrets Manager 같은 신뢰 저장소에서 관리해야 한다.
LLM 앞에 Presidio를 두는 이유
LLM이 개인정보를 출력하지 않도록 검사하는 것만으로는 입력 노출을 막지 못한다. 가장 기본적인 배치는 모델 호출 전에 원문을 Analyzer와 Anonymizer에 통과시키는 것이다.
사용자 입력·업로드 문서
  → Presidio 탐지
  → 업무 정책에 따른 비식별화
  → LLM 호출
  → LLM 출력 재검사
  → 사용자
입력과 출력에 모두 검사가 필요한 이유가 있다. 입력에는 사용자가 제공한 개인정보가 있고, 출력에는 모델이 대화 기록·검색 문서·도구 결과에서 가져온 개인정보가 나타날 수 있다. 다만 같은 문장을 여러 단계에서 무조건 중복 마스킹하면 문맥과 품질이 손상되므로 각 경계의 목적을 명확히 해야 한다.
RAG에서는 어디에 배치해야 하는가
RAG는 질문과 관련된 문서를 Vector DB에서 찾아 원문 청크를 LLM 프롬프트에 넣는 방식이다. Presidio는 임베딩 벡터 자체를 의미 있게 검사하는 도구가 아니다. 검색 후 반환된 원문 청크를 검사해야 한다.
권장 흐름은 다음과 같다.
Application: 인증·Tenant 확정
  → Retrieval API: Tenant Filter와 문서 권한 적용
  → Vector DB 검색
  → 반환된 원문 청크
  → Presidio: PII 탐지·비식별화
  → LLM 프롬프트 조립
Presidio는 Tenant 권한을 판단하지 않는다. 접근하면 안 되는 문서를 먼저 검색해 놓고 개인정보만 마스킹하는 것은 올바른 인가가 아니다. 문서 접근통제와 Security Trimming을 먼저 적용하고, 허용된 원문의 개인정보를 추가로 검사해야 한다.
NeMo Guardrails와 함께 쓴다면 Retrieval Rail의 Custom Action에서 Presidio를 호출하거나 Application 소유 검색 API 안에서 호출할 수 있다. NeMo가 전체 LLM 흐름을 조정하고 Presidio는 요청받은 텍스트의 PII를 처리한다.
라이브러리와 HTTP 서비스 중 무엇을 선택할까
Python 애플리케이션이라면 presidio-analyzer와 presidio-anonymizer를 같은 프로세스에 설치하는 방식이 가장 단순하다. 네트워크 전송이 없고 세밀한 사용자 정의가 쉽지만 NLP 모델이 애플리케이션 메모리와 시작 시간을 차지한다.
여러 언어의 애플리케이션이나 여러 팀이 공통 정책을 사용한다면 Analyzer와 Anonymizer를 HTTP 서비스로 분리할 수 있다. 공식 설치 문서는 현재 GHCR의 data-privacy-stack 이미지를 안내하며, 운영 환경에서는 latest 대신 명시적인 릴리스 태그 고정을 권한다.
podman run -d --name presidio-analyzer \
  -p 5002:3000 \
  ghcr.io/data-privacy-stack/presidio-analyzer:latest

podman run -d --name presidio-anonymizer \
  -p 5001:3000 \
  ghcr.io/data-privacy-stack/presidio-anonymizer:latest
튜토리얼에서는 latest가 편하지만 운영 배포에서는 검증한 버전 태그와 이미지 Digest를 고정해야 한다. 서비스 분리는 정책 중앙화에 유리한 반면, 원문 개인정보가 네트워크를 한 번 더 이동하므로 TLS, 서비스 인증, 요청 로그 마스킹과 타임아웃이 필요하다.
Presidio를 꼭 써야 하는 경우
- LLM 프롬프트나 응답에서 PII를 일관되게 탐지·마스킹해야 한다.
- 로그, 데이터 분석과 외부 공유에 같은 비식별화 정책을 재사용해야 한다.
- 정규식 외에 NER, 문맥, 체크섬과 사용자 정의 Recognizer가 필요하다.
- Python 라이브러리와 HTTP 서비스 중 배포 방식을 선택해야 한다.
- 엔터티별로 삭제·부분 마스킹·해시·암호화 정책을 다르게 적용해야 한다.
반대로 입력 필드가 엄격히 구조화되어 있고 이메일 한 필드만 제거하면 되는 작은 서비스라면 단순 검증 코드가 더 적절할 수 있다. Presidio의 가치는 다양한 비정형 텍스트와 여러 정책을 반복적으로 처리할 때 커진다.
반드시 알아야 할 한계
Presidio는 모든 개인정보를 자동으로 찾는 완전한 DLP 제품이 아니다. 언어와 도메인별로 오탐·미탐이 있으며, 새로운 식별자와 결합식별자는 기본 Recognizer가 모를 수 있다. 이름을 지워도 직장, 희귀 질환, 날짜와 지역을 조합하면 개인을 다시 알아볼 수 있다.
또한 탐지 결과를 로그에 그대로 남기면 보호하려던 원문이 관측 시스템에 복제될 수 있다. 디버깅용 decision trace, API 요청·응답, 오류 메시지와 샘플 데이터를 모두 개인정보 처리 대상으로 다뤄야 한다.
성능도 검토해야 한다. 정규식만 사용하는 것보다 NLP 모델을 함께 실행하면 정확도 개선 가능성이 있지만 CPU·GPU, 메모리와 지연시간이 늘어난다. 실제 데이터의 언어·길이·엔터티 분포를 반영한 테스트 세트로 임계값과 Recognizer를 조정해야 한다.
결론
Microsoft Presidio는 LLM 보안 전체를 책임지는 가드레일 플랫폼이 아니다. 원문에서 개인정보 후보를 찾는 Analyzer와, 정책에 따라 값을 바꾸는 Anonymizer를 제공하는 전문 엔진이다.
Presidio를 써야 하는 이유는 개인정보 보호를 “모델에게 부탁하는 문장”이 아니라 모델 호출 전후에 실행되는 데이터 처리 단계로 만들기 위해서다. 그러나 Tenant 권한, 법적 처리 근거, 암호화 키, 최종 접근 승인은 애플리케이션과 신뢰할 수 있는 보안 계층이 맡아야 한다.
정확한 배치는 간단하다. 먼저 인증과 문서 권한을 강제하고, 허용된 원문을 Presidio로 탐지·비식별화한 뒤 LLM이나 분석 시스템에 전달한다. 이 책임 분리를 지키면 Presidio는 LLM·RAG·로그 파이프라인에서 개인정보 노출 범위를 실질적으로 줄이는 강력한 구성 요소가 된다.
공식 참고 자료
'일반IT > IT보안' 카테고리의 다른 글
| 증거에서 대응까지: LLM 보안 사고 조사 (0) | 2026.09.03 |
|---|---|
| 소프트웨어 공급망 보안 입문: 무엇을 공부하고 어떤 도구로 검증할까 (0) | 2026.09.02 |
| Application이 지휘할까, NeMo Guardrails가 지휘할까? LLM 보안 오케스트레이션의 책임 분리 (0) | 2026.08.21 |
| LLM으로 KongTuke 난독화 JavaScript 분석하기 — PCAP에서 ClickFix 네트워크 행위까지 (0) | 2026.08.09 |
| Claude Code를 보안 코파일럿으로 만드는 19개 Skill — Claude-Code-CyberSecurity-Skill 구조와 안전한 실습 (0) | 2026.08.08 |


