LLM 서비스를 설계하다 보면 곧 이런 질문을 만나게 됩니다. 사용자의 입력부터 RAG 검색, 가드레일, LLM 호출, 도구 실행, 최종 응답까지 Application이 모두 지휘해야 할까요? 아니면 NeMo Guardrails를 중심에 두고 Application은 앞뒤만 담당해야 할까요?
먼저 결론부터 말하면, 둘 중 하나를 유일한 중심으로 정하는 문제가 아닙니다. Application 또는 신뢰할 수 있는 API 계층은 보안·업무 제어의 중심이고, NeMo Guardrails Runtime은 LLM 처리 파이프라인의 중심입니다. Application은 인증, 인가, Tenant 경계, 업무 권한, 최종 승인과 감사 추적을 책임집니다. NeMo는 Input Rail, Retrieval Rail, Dialog Rail, Execution Rail, LLM 호출, Output Rail을 구성에 따라 조정합니다.
따라서 “모든 네트워크 요청을 하나의 Application 프로세스가 직접 중계해야 한다”는 문장은 OWASP나 Microsoft, NVIDIA의 단일한 공식 원칙이 아닙니다. 최소 권한, 완전한 중재(Complete Mediation), 신뢰할 수 있는 서비스 계층, 데이터 접근 API 캡슐화 같은 원칙을 조합해 도출할 수 있는 권장 설계안 중 하나입니다. 중요한 것은 물리적으로 모든 패킷이 같은 프로세스를 통과하는지가 아니라, 보호된 데이터와 기능에 접근하는 모든 경로에서 같은 권한 정책이 빠짐없이 집행되는가입니다.
먼저 용어부터 짚고 가자
이 글에서 사용하는 네 가지 용어는 다음과 같습니다.
- RAG(Retrieval-Augmented Generation): 사용자의 질문과 관련된 외부 문서를 먼저 검색하고, 그 문서 조각을 LLM 프롬프트에 근거 자료로 넣어 답변을 생성하는 방식입니다.
- Rail: NeMo Guardrails에서 요청 처리의 특정 단계에 적용하는 프로그래밍 가능한 정책과 흐름입니다. 입력을 차단하거나, 검색 결과를 변환하거나, 도구 실행을 통제하고, 모델 출력을 검사할 수 있습니다.
- Tenant Filter: 다중 고객 환경에서 현재 사용자가 속한 Tenant와 권한 범위에 해당하는 데이터만 검색되도록 제한하는 조건입니다. 단순히 tenant_id 하나만 비교하는 것이 아니라 문서 등급, 사용자 역할, 소유권 같은 보안 필터를 함께 적용할 수 있습니다.
- Presidio: 텍스트에서 이름, 전화번호, 이메일 같은 PII(Personally Identifiable Information, 개인식별정보)를 탐지하고 익명화하는 엔진입니다. 전체 LLM 파이프라인을 지휘하는 오케스트레이터는 아닙니다.
여기서 인증(Authentication)은 “누구인가”를 확인하는 과정이고, 인가(Authorization)는 “그 사용자가 이 데이터나 기능을 사용할 수 있는가”를 판단하는 과정입니다. 가드레일은 허용된 LLM 행동과 콘텐츠 정책을 집행하지만, 사용자의 최종 업무 권한을 대신 판단해서는 안 됩니다.
Hub-and-Spoke는 두 가지 의미로 나눠야 한다
“Application 중심 Hub-and-Spoke가 안전하다”는 설명은 자주 쓰이지만, 무엇을 중심에 둔다는 것인지 분명히 해야 합니다.
1. 네트워크 프록시 중심 Hub
모든 브라우저, NeMo, 검색 시스템, LLM, 도구 사이의 통신을 하나의 Application 프로세스가 직접 중계하는 구조입니다. 경로가 단순하고 한곳에서 로깅하기 쉽다는 장점이 있습니다. 반면 처리량이 늘면 병목이 생기고, 장애 시 전체 서비스가 멈추는 단일 장애점이 될 수 있습니다. Application 코드가 인증, 검색, 프롬프트 조립, 가드레일, 도구 제어까지 모두 떠안으면 변경 영향 범위도 커집니다.
2. 보안 제어 중심 Hub
보호된 데이터와 기능에 접근하는 모든 경로가 신뢰할 수 있는 접근통제 메커니즘을 거치도록 하는 구조입니다. 이 메커니즘은 하나의 모놀리식 Application일 수도 있지만, API Gateway, 인증 서비스, Retrieval API, 정책 결정·집행 지점으로 분리될 수도 있습니다. 핵심은 단일 프로세스가 아니라 우회할 수 없는 일관된 정책 경로입니다.
이 글은 두 번째 의미의 Hub를 권장합니다. 네트워크 토폴로지는 분산할 수 있지만, 인증·인가와 Tenant 경계는 Application이 소유한 신뢰 영역에서 일관되게 집행해야 합니다.
OWASP는 Application 중심 구조를 권장하는가
정확히 말하면 OWASP는 특정 제품 배치를 지정하지 않고, 접근통제와 에이전트 권한에 관한 보안 원칙을 제시합니다.
OWASP LLM06:2025 Excessive Agency
OWASP LLM06:2025 Excessive Agency는 LLM 기반 시스템이 과도한 기능, 과도한 권한, 과도한 자율성을 가질 때 위험한 작업을 수행할 수 있다고 설명합니다. 주요 완화책은 다음과 같습니다.
- LLM이 호출할 수 있는 확장 기능과 각 기능의 범위를 최소화합니다.
- 셸 명령 실행처럼 범용적인 도구보다 목적이 좁은 도구를 제공합니다.
- 다운스트림 시스템에 연결하는 도구의 권한을 최소화합니다.
- 사용자 대신 수행하는 작업은 그 사용자의 보안 문맥과 최소 권한으로 실행합니다.
- 영향이 큰 작업에는 사람의 승인을 요구합니다.
- Complete Mediation을 적용해 다운스트림 시스템으로 가는 모든 요청을 보안 정책으로 검증합니다.
- 작업 허용 여부를 LLM이 결정하게 두지 말고 다운스트림 시스템이 인가를 강제합니다.
이 원칙은 “Application이 모든 네트워크 요청을 직접 프록시하라”는 말과 다릅니다. 예를 들어 NeMo의 Custom Action이 Retrieval API를 호출하더라도 Retrieval API가 검증된 사용자 문맥으로 권한을 다시 확인한다면 Complete Mediation을 충족할 수 있습니다. 반대로 모든 트래픽이 Application을 거쳐도 Application이 고권한 공용 계정으로 Vector DB를 조회한다면 사용자 문맥과 최소 권한 원칙을 위반할 수 있습니다.
OWASP ASVS 4.0
OWASP ASVS 4.0의 아키텍처 요구사항은 접근통제를 신뢰할 수 있는 집행 지점에서 적용하고, 보호된 데이터와 자원에는 단일하고 충분히 검증된 접근통제 메커니즘을 사용하라고 요구합니다. V4 Access Control도 우회 가능한 클라이언트가 아니라 신뢰할 수 있는 서비스 계층에서 접근통제 규칙을 집행하고 최소 권한을 적용하도록 합니다.
여기서 ASVS가 말하는 “trusted service layer”는 하나의 전통적인 서버 프로세스만을 뜻하지 않습니다. ASVS 4.0 문서는 접근통제 게이트웨이, 서버, 서버리스 함수, 마이크로서비스 같은 신뢰 가능한 집행 지점을 폭넓게 설명합니다. 그러므로 ASVS의 “single mechanism”을 “모든 요청이 동일한 Application 바이너리를 통과해야 한다”로 해석하는 것은 과도합니다. 더 정확한 해석은 권한 판단이 복제되거나 우회되는 대체 경로를 만들지 말라는 것입니다.
Microsoft의 다중 Tenant RAG 설계가 말하는 것
Microsoft의 보안 다중 Tenant RAG 아키텍처는 사용자가 지능형 Application에 요청하고, Identity Provider가 사용자를 인증하며, Application이 사용자 쿼리와 권한 토큰을 Orchestrator API에 전달하는 흐름을 설명합니다. Orchestrator는 관련 근거 데이터를 가져와 모델에 전달합니다.
다중 Tenant 환경에서 문서는 특히 다음을 강조합니다.
- 사용자의 신원은 요청 체인을 따라 Orchestrator와 데이터 저장소까지 전달되어야 합니다.
- 공유 저장소를 조회할 때는 Tenant 식별자를 쿼리 조건에 포함해야 합니다.
- 사용자가 허용된 문서만 보도록 Filtering 또는 Security Trimming을 적용해야 합니다.
- 저장소 앞에 API 계층을 두어 Tenant별 라우팅, 사용자 신원 사용, 보안 필터, 접근 로그를 캡슐화하는 방식을 권장합니다.
- Tenant 데이터에 접근하는 코드는 백엔드 저장소를 직접 조회하지 않고 이 API 계층을 거쳐야 합니다.
여기서 “모든 요청”은 Tenant 데이터 저장소에 대한 접근이라는 문맥입니다. Microsoft 문서는 전체 LLM 시스템의 모든 통신을 하나의 Application 프로세스로 프록시하라고 요구하지 않습니다. 오히려 지능형 Application, Identity Provider, Orchestrator, 데이터 접근 API, 저장소, Foundation Model을 별도 구성 요소로 표현합니다.
즉 Microsoft가 권장하는 중심은 모놀리식 Application이 아니라, Tenant 데이터 권한 로직을 캡슐화한 데이터 접근 API라는 해석이 더 정확합니다.
NVIDIA NeMo Guardrails의 공식 아키텍처
NVIDIA NeMo Guardrails Architecture Overview는 NeMo Guardrails가 Application과 LLM·Tool·Retrieval System 사이에 위치한다고 설명합니다. Application은 Python SDK 또는 Guardrails Server로 메시지를 보내고 최종 응답을 받습니다. Runtime은 설정을 읽고 이벤트를 처리하며 Rail, Custom Action, Retrieval, LLM 요청을 조정합니다.
NVIDIA 문서의 구성 관계를 단순화하면 다음과 같습니다. Application은 NeMo Runtime이라는 단일 Guardrails 인터페이스를 호출하고, Runtime이 허브가 되어 각 Rail과 외부 LLM·검색·Tool을 조정합니다.

그림 1. NVIDIA 공식 아키텍처 설명을 바탕으로 재구성한 Hub-and-Spoke 구성도. NeMo Runtime이 허브이고 Rail 및 외부 시스템이 논리적 spoke입니다. Rail은 별도 네트워크 서비스가 아니라 Runtime이 실행하는 내부 정책 단계이며, 선은 물리적 통신 경로가 아닌 조정 관계를 뜻합니다. 공식 문서
구성도와 요청 순서는 구분해서 읽어야 합니다. 공식 문서가 설명하는 일반적인 평가 순서는 Input → Retrieval → Dialog → Execution → Output Rail이지만, Runtime은 이벤트 기반이므로 설정과 대화 흐름에 따라 검색, Custom Action과 LLM 호출 시점이 달라질 수 있습니다.
각 Rail의 역할은 다음과 같습니다.
- Input Rail: Application LLM을 호출하기 전에 사용자 메시지를 허용, 변경 또는 거부합니다.
- Retrieval Rail: Knowledge Base나 외부 검색에서 가져온 원문 청크를 프롬프트에 넣기 전에 필터링하거나 변환합니다.
- Dialog Rail: Colang Flow와 이벤트를 사용해 다음 대화 단계를 정하거나 응답과 Action 실행 여부를 조정합니다.
- Execution Rail: Custom Action과 Tool의 입력·출력을 검증하고 실행을 통제합니다.
- Output Rail: 생성된 응답을 사용자에게 반환하기 전에 허용, 수정 또는 차단합니다.
이 흐름에서 NeMo는 분명한 LLM 파이프라인 오케스트레이터입니다. Application이 동일한 Rail 순서를 다시 구현할 필요는 없습니다. 다만 NVIDIA 문서가 NeMo에 사용자 계정의 최종 접근 권한이나 Tenant 소유권 판정을 맡기라고 설명하는 것은 아닙니다. NeMo가 Custom Action을 호출할 수 있다는 사실과, 그 Action을 실행할 업무 권한이 있다는 사실은 별개입니다.
NeMo에서 가능한 두 가지 RAG 통합 방식
NVIDIA의 RAG 통합 튜토리얼은 두 방식을 모두 설명합니다. 따라서 한 가지만 NeMo의 공식 표준이라고 단정해서는 안 됩니다.
방식 1: Relevant Chunks를 Application이 전달
Application 또는 Application이 소유한 Retrieval API가 먼저 검색합니다. 이때 인증된 사용자와 Tenant를 기준으로 필터와 Security Trimming을 적용합니다. 검색된 원문 청크는 relevant_chunks 컨텍스트로 NeMo의 generate 호출에 전달합니다.
장점은 데이터 접근 권한을 기존 업무 API와 같은 방식으로 관리하기 쉽고, Vector DB 자격증명을 NeMo에 직접 부여하지 않아도 된다는 점입니다. 반면 Application이 검색 흐름과 오류 처리, NeMo 컨텍스트 전달까지 구현해야 하므로 Application 쪽 책임이 늘어납니다.
방식 2: NeMo가 Knowledge Base와 검색을 관리
NeMo 설정의 Knowledge Base를 사용하거나, Custom retrieve_relevant_chunks Action 또는 Custom EmbeddingSearchProvider를 연결해 Runtime이 검색 단계를 관리합니다. LLM 파이프라인 구성이 한곳에 모이므로 실험과 정책 변경이 편리할 수 있습니다.
그러나 “NeMo가 검색을 관리한다”는 말은 “NeMo가 사용자 권한을 결정한다”는 뜻이 아닙니다. Custom Action 또는 외부 검색 API는 Application이 검증해 전달한 사용자·Tenant 문맥을 신뢰할 수 있는 방식으로 받아야 하고, 저장소 접근 시 그 권한을 다시 강제해야 합니다. 프롬프트에 적힌 tenant_id나 LLM이 추론한 사용자 역할을 인가 근거로 사용해서는 안 됩니다.
두 방식의 선택 기준은 검색 책임의 위치입니다. 기존 데이터 접근 API와 권한 모델이 성숙했다면 Relevant Chunks 방식이 자연스럽습니다. 독립형 지식봇이고 데이터 격리 요구가 단순하다면 NeMo 관리 방식도 가능합니다. 다중 Tenant와 세밀한 문서 권한이 핵심이라면, NeMo가 검색 호출을 시작하더라도 실제 조회는 권한을 강제하는 Retrieval API를 거치게 하는 편이 안전합니다.
Presidio는 어디에 배치해야 하는가
Microsoft Presidio Analyzer는 비정형 텍스트에서 PII를 탐지하는 Python 기반 엔진입니다. Python 라이브러리의 AnalyzerEngine으로 프로세스 내부에서 호출할 수도 있고, HTTP 서비스로 배포해 호출할 수도 있습니다. 탐지 결과를 Presidio Anonymizer에 넘겨 마스킹이나 대체 처리를 구성할 수도 있습니다.
Presidio는 전체 파이프라인 오케스트레이터가 아니라 텍스트 PII 검사기입니다. 따라서 온라인 RAG 흐름에서는 임베딩 벡터 자체가 아니라, Vector DB 검색 후 반환된 원문 청크를 검사하는 것이 맞습니다. 임베딩은 의미 검색을 위한 수치 표현이므로 원문에 포함된 이름과 전화번호의 정확한 위치를 PII 엔진이 검사하고 익명화할 입력으로 삼기 어렵습니다.
배치 위치는 두 가지가 가능합니다.
- Application 소유 검색 계층에서 호출: Retrieval API가 Tenant Filter로 검색한 직후 Presidio를 호출하고, 안전한 청크만 NeMo에 반환합니다. 데이터가 NeMo 경계에 들어오기 전에 최소화된다는 장점이 있습니다.
- NeMo Retrieval Rail의 Custom Action에서 호출: 검색된 원문 청크가 프롬프트에 들어가기 직전에 Presidio를 호출합니다. 가드레일 정책과 PII 처리를 함께 추적하기 쉽습니다.
이 글의 권장 설계안은 권한 필터와 PII 검사를 순서상 분리합니다. Tenant Filter와 문서 인가는 Retrieval API에서 먼저 적용하고, 그 결과로 반환된 원문 청크를 NeMo Retrieval Rail에서 Presidio로 검사합니다. Presidio가 문서를 마스킹한다고 해도 다른 Tenant 문서를 검색해도 된다는 뜻은 아니기 때문입니다. 권한 없는 데이터는 애초에 검색 결과에 포함되지 않아야 합니다.
또한 최종 Output Rail에서 생성 응답을 다시 PII 검사하는 방어층을 둘 수 있습니다. 하지만 출력 검사는 검색 전 인가를 대체하지 않습니다. LLM이 이미 권한 없는 원문을 받았다면 출력 차단 이전에 보안 경계가 무너진 것입니다.
권장 혼합 아키텍처
다음은 OWASP의 최소 권한과 Complete Mediation, ASVS의 신뢰할 수 있는 접근통제 계층, Microsoft의 Tenant 데이터 API 캡슐화, NVIDIA의 Runtime 오케스트레이션을 조합한 이 글의 권장 설계안입니다. 특정 문서 하나가 이 배치를 그대로 공식 표준으로 규정한 것은 아닙니다.
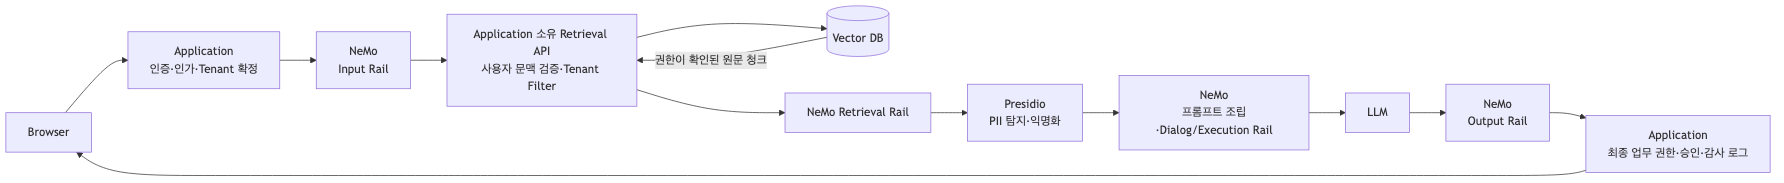
그림 2. 권장 혼합 아키텍처. 공식 보안 원칙과 제품 기능을 조합한 이 글의 해석이며, 단일 제품의 공식 참조 아키텍처를 그대로 옮긴 그림은 아닙니다.
요청은 다음 순서로 처리됩니다.
- Browser가 Application에 요청합니다.
- Application이 IdP 결과를 검증하고 사용자, Tenant, 역할, 요청 가능한 업무 기능을 확정합니다.
- Application이 조작하기 어려운 서버 측 문맥과 상관관계 ID를 NeMo에 전달합니다.
- NeMo Input Rail이 프롬프트 인젝션, 허용 주제, 형식 같은 입력 정책을 검사합니다.
- 검색이 필요하면 NeMo가 Application 소유 Retrieval API를 호출합니다.
- Retrieval API가 토큰 또는 위임된 사용자 문맥을 검증하고 Tenant Filter와 문서 수준 Security Trimming을 적용합니다.
- 검색된 원문 청크를 NeMo Retrieval Rail로 돌려보내고, Custom Action이 Presidio를 호출해 PII를 탐지·익명화합니다.
- NeMo가 정제된 청크로 프롬프트를 조립하고 Dialog·Execution Rail을 거쳐 LLM을 호출합니다.
- NeMo Output Rail이 생성 응답의 안전 정책과 필요시 PII를 다시 검사합니다.
- Application이 세션과 업무 권한이 여전히 유효한지 확인하고, 고위험 작업이면 최종 승인을 요구하며, 감사 로그를 남긴 뒤 응답합니다.
여기서 10단계의 최종 확인은 6단계의 데이터 인가를 대체하지 않습니다. 데이터 권한은 검색 전에 강제해야 하고, 최종 확인은 세션 폐기, 권한 변경, 고위험 업무 승인, 응답 전달 정책을 다루는 추가 방어층입니다.
세 가지 오케스트레이션 방식 비교
| 비교 기준 | Application 직접 오케스트레이션 | NeMo Runtime 오케스트레이션 | Application + NeMo 혼합형 |
| 인증·인가 책임 | Application이 직접 담당 | NeMo 앞의 Application·Gateway 또는 각 다운스트림 API가 담당해야 함. NeMo·LLM에 최종 판단을 맡기지 않음 | Application과 신뢰 API가 사용자·Tenant·업무 권한을 담당 |
| RAG 검색 책임 | Application이 검색, Tenant Filter, Security Trimming, 컨텍스트 조립을 수행 | NeMo Knowledge Base, retrieve_relevant_chunks Action 또는 EmbeddingSearchProvider가 흐름을 관리. 실제 권한 집행은 검색 API·저장소에서 수행 | NeMo가 검색 시점을 조정하고 Application 소유 Retrieval API가 권한 필터를 집행 |
| 가드레일 실행 | Application 코드나 별도 미들웨어로 직접 조합 | NeMo Runtime이 Input·Retrieval·Dialog·Execution·Output Rail을 실행 | LLM 관련 가드레일은 NeMo, 업무 유효성 검사는 Application이 담당 |
| LLM 호출 | Application이 직접 호출 | NeMo Runtime이 구성에 따라 호출 | NeMo가 호출하고 Application은 모델 자격증명·허용 모델·비용 한도 정책을 외부에서 통제 가능 |
| 확장성 | 단일 코드베이스는 시작이 단순하지만 기능 증가 시 결합도와 병목이 커질 수 있음 | Rail과 Action을 독립 확장하기 좋지만 Runtime 용량 계획과 외부 서비스 장애 처리가 필요 | 구성 요소별 독립 확장이 가능하지만 서비스 간 계약과 추적 체계가 필요 |
| 정책 추적성 | 한 저장소에 모으기 쉽지만 보안 정책과 대화 정책이 뒤섞일 수 있음 | Rail 설정과 Colang 흐름을 중심으로 LLM 정책을 추적하기 좋음 | 업무 권한 정책과 LLM 정책의 소유권을 나눌 수 있으나 상관관계 ID와 통합 감사가 필요 |
| 구현 복잡도 | 초기에는 낮을 수 있으나 RAG·Tool·Rail 증가에 따라 빠르게 높아질 수 있음 | LLM 흐름 구현은 단순해지지만 NeMo 운영과 Colang 학습 비용이 생김 | 초기 복잡도가 가장 높고 정책 중복 위험이 있으므로 명확한 책임표가 필요 |
| 적합한 사용 사례 | 단순한 단일 Tenant 챗봇, 기존 Application 코드 중심의 작은 시스템 | 독립형 지식봇, 복잡한 대화·도구 흐름, LLM 정책 실험이 잦은 시스템 | 다중 Tenant, 세밀한 문서 권한, 규제 데이터, 여러 Tool과 승인 절차가 있는 운영 시스템 |
어느 방식이 항상 우월한 것은 아닙니다. 단순한 챗봇에 혼합형을 적용하면 운영 복잡도만 늘 수 있고, 복잡한 다중 Tenant 에이전트를 Application 하나로 구현하면 변경과 장애의 영향 범위가 지나치게 커질 수 있습니다.
인증·인가와 가드레일 집행을 어떻게 분리할까
책임을 가장 단순하게 나누면 다음과 같습니다.
Application 또는 신뢰할 수 있는 API 계층의 책임
- 로그인 세션과 토큰 검증
- 사용자와 Tenant의 권위 있는 매핑
- RBAC·ABAC·문서 소유권 같은 업무 인가
- Retrieval API의 Tenant Filter와 Security Trimming
- 다운스트림 Tool의 최소 권한 자격증명과 사용자 문맥 전달
- 결제, 삭제, 외부 전송 같은 고위험 작업의 최종 승인
- 요청·검색 문서·Tool 실행·응답을 연결하는 감사 로그
- Rate Limit, 비용 한도, 세션 폐기와 사고 대응
NeMo Guardrails의 책임
- 유해하거나 허용 범위를 벗어난 입력 검사
- 검색된 원문 청크의 필터링·변환과 PII 검사 호출
- 대화 상태와 허용된 흐름 관리
- Tool·Custom Action 입력과 출력의 LLM 정책 검사
- LLM 호출과 응답 생성 흐름 조정
- 생성 출력의 안전성, 형식, 주제, PII 검사
- 거부 응답 또는 안전한 대체 응답 생성
이 구분에서 가장 중요한 규칙은 LLM이나 NeMo가 사용자 최종 접근 권한의 권위 있는 결정자가 되어서는 안 된다는 것입니다. NeMo의 Rail이 “이 사용자는 관리자처럼 보인다”고 판단해도 그것은 인가 근거가 아닙니다. 인가는 IdP, 정책 엔진, Application 데이터, Retrieval API, 다운스트림 시스템처럼 결정론적이고 감사 가능한 계층에서 강제해야 합니다.
혼합형에서 자주 생기는 실패
Application과 NeMo가 같은 정책을 서로 다르게 구현한다
Application은 주민등록번호를 차단하지만 NeMo는 마스킹해 허용하는 식으로 정책이 갈리면 결과를 예측하기 어렵습니다. 정책마다 결정 소유자와 집행 위치를 한 곳으로 정하고, 다른 계층의 검사는 방어 심층용인지 최종 결정용인지 표시해야 합니다.
Tenant ID를 사용자 입력이나 프롬프트에서 가져온다
Tenant ID는 로그인 후 서버가 확정한 신원 문맥에서 가져와야 합니다. Browser가 보낸 JSON 필드나 LLM이 추론한 조직명을 그대로 쿼리 필터로 사용하면 Tenant 경계를 우회할 수 있습니다.
NeMo에 고권한 저장소 자격증명을 준다
NeMo가 검색을 관리하더라도 읽기 전용·Tenant 제한 자격증명 또는 권한 검증 Retrieval API를 사용해야 합니다. 공용 관리자 계정으로 Vector DB 전체를 조회한 뒤 Rail에서만 걸러내는 구조는 최소 권한과 Complete Mediation에 맞지 않습니다.
최종 Output Rail만 믿는다
출력 차단은 유출 가능성을 줄이지만, 권한 없는 데이터가 이미 검색되고 LLM 프롬프트에 들어가는 것을 정당화하지 못합니다. 권한 검사는 검색 전에, PII 최소화는 프롬프트 조립 전에, 출력 검사는 반환 전에 각각 수행해야 합니다.
모든 것을 한 Hub에 넣어 병목과 단일 장애점을 만든다
보안 제어의 일관성을 확보하겠다는 이유로 모든 로직을 하나의 Application에 넣으면 배포와 장애가 전체 경로에 영향을 줍니다. 접근통제 정책의 단일성을 유지하되, Retrieval API와 NeMo Runtime을 독립적으로 확장하고 타임아웃, 회로 차단, 실패 시 안전한 거부를 설계해야 합니다.
실무 적용 체크리스트
신원과 권한
- [ ] Browser가 보낸 Tenant ID가 아니라 IdP와 서버 측 매핑으로 Tenant를 확정하는가?
- [ ] 사용자 신원과 권한 범위가 Retrieval API와 Tool까지 위조하기 어려운 형태로 전달되는가?
- [ ] NeMo 또는 LLM의 자연어 판단을 최종 인가 근거로 사용하지 않는가?
- [ ] 각 다운스트림 시스템이 요청마다 권한을 재검증하는가?
- [ ] 고위험 작업은 사용자 확인이나 별도 승인 절차를 거치는가?
RAG와 개인정보
- [ ] 공유 Vector DB 쿼리에 Tenant Filter가 강제로 포함되는가?
- [ ] Tenant 내부에서도 문서·행·등급 수준의 Security Trimming이 필요한지 정의했는가?
- [ ] 권한 없는 원문이 NeMo나 LLM 컨텍스트에 들어가기 전에 차단되는가?
- [ ] Presidio는 임베딩이 아니라 검색 후 반환된 원문 청크를 검사하는가?
- [ ] PII 탐지 실패, Presidio 장애, 익명화 오류가 발생하면 안전하게 거부하거나 제한하는가?
- [ ] 필요하다면 Output Rail에서 생성 응답을 다시 PII 검사하는가?
오케스트레이션과 운영
- [ ] 인증·인가 정책과 LLM Rail 정책의 소유자를 문서화했는가?
- [ ] Relevant Chunks 방식과 NeMo 관리 방식 중 선택 근거를 기록했는가?
- [ ] NeMo Custom Action과 Tool에 최소 기능·최소 권한을 적용했는가?
- [ ] Application, NeMo, Retrieval API, LLM, Tool 로그를 하나의 상관관계 ID로 연결할 수 있는가?
- [ ] 로그에 원문 PII, 토큰, 프롬프트 비밀정보를 과도하게 남기지 않는가?
- [ ] NeMo 또는 Retrieval API 장애 시 우회 경로로 LLM이나 Vector DB를 직접 호출하지 않는가?
- [ ] 각 구성 요소의 타임아웃, 재시도, 회로 차단, Rate Limit, 비용 한도를 정의했는가?
- [ ] Rail 정책과 업무 권한 정책이 중복되거나 충돌하는지 회귀 테스트하는가?
결론: 중심은 하나가 아니라 책임별로 둘이다
Application 중심 설계를 지지하는 보안 근거는 분명합니다. OWASP는 최소 권한, 사용자 문맥, Complete Mediation과 다운스트림 인가를 강조합니다. ASVS는 신뢰할 수 있는 서비스 계층과 일관된 접근통제 메커니즘을 요구합니다. Microsoft는 다중 Tenant RAG에서 Tenant Filter, Security Trimming, 접근 로그를 데이터 접근 API에 캡슐화할 것을 권장합니다.
하지만 이 근거들이 “모든 통신을 하나의 Application 프로세스가 직접 중계해야 한다”는 제품 독립적인 공식 원칙을 만들지는 않습니다. 그것은 시스템의 위험, 조직 구조와 운영 조건을 반영해 선택할 수 있는 설계안입니다.
반면 NVIDIA는 NeMo Guardrails Runtime이 Rail, Custom Action, Retrieval, LLM 호출을 조정하는 구조를 공식적으로 설명합니다. 따라서 NeMo를 LLM 처리 흐름의 중심에 두는 것은 자연스럽습니다. 다만 NeMo의 파이프라인 오케스트레이션과 사용자의 업무 인가는 같은 책임이 아닙니다.
정리하면 Application은 보안·업무 제어의 중심이고, NeMo는 LLM 처리 파이프라인의 중심입니다. RAG 검색은 두 방식 모두 가능하지만, Tenant와 문서 권한은 신뢰할 수 있는 Retrieval API 또는 저장소가 강제해야 합니다. Presidio는 권한이 확인된 검색 원문의 PII를 검사하는 엔진으로 배치합니다. 그리고 LLM이나 NeMo가 사용자의 최종 접근 권한을 판단하게 해서는 안 됩니다.
공식 출처
- OWASP LLM06:2025 Excessive Agency
- OWASP ASVS 4.0 PDF
- OWASP ASVS 4.0 Architecture Requirements 원문
- OWASP ASVS 4.0 Access Control Requirements 원문
- Microsoft: Design a secure multitenant RAG inferencing solution
- NVIDIA NeMo Guardrails Architecture Overview
- NVIDIA NeMo Guardrails RAG integration
- Microsoft Presidio Analyzer
'일반IT > IT보안' 카테고리의 다른 글
| 소프트웨어 공급망 보안 입문: 무엇을 공부하고 어떤 도구로 검증할까 (0) | 2026.09.02 |
|---|---|
| Microsoft Presidio 집중 탐구: 개인정보를 LLM에 보내기 전에 왜 필요한가 (0) | 2026.09.02 |
| LLM으로 KongTuke 난독화 JavaScript 분석하기 — PCAP에서 ClickFix 네트워크 행위까지 (0) | 2026.08.09 |
| Claude Code를 보안 코파일럿으로 만드는 19개 Skill — Claude-Code-CyberSecurity-Skill 구조와 안전한 실습 (0) | 2026.08.08 |
| [보안 프롬프트 설계와 작성 실무 5] 악성코드 스크립트 난독화 정적 분석하기 (0) | 2026.08.07 |


