OpenTelemetry(오픈텔레메트리, 줄여서 OTel)는 애플리케이션이 남기는 추적·메트릭·로그를 한 가지 공통 방식으로 수집하고 전달하기 위한 공개 표준입니다. 쉽게 말하면, 서로 다른 기계가 제각각 쓰던 관찰 일지를 같은 양식으로 맞춰 주는 번역 규칙입니다.
그런데 LLM 서비스에서 정말 보고 싶은 것은 “모델 API가 성공했는가?” 하나가 아닙니다. 답변은 느렸지만 검색이 늦었던 것인지, 모델의 첫 토큰이 늦었던 것인지, 도구 호출이 재시도되었는지, 엉뚱한 문서를 검색했는지까지 알아야 합니다. 모델 호출만 기록하면 긴 여행의 출발지와 도착지만 보고 중간에 어디서 길을 잃었는지는 모르는 셈입니다.
결론부터 말하면 OTel을 LLM 관측성의 기반으로 선택하는 방향은 현재의 표준 흐름에 맞습니다. 다만 OTel의 핵심 추적·메트릭 체계와 LLM 전용 gen_ai.* 규약의 성숙도는 구분해야 합니다. 전자는 폭넓게 안정화되어 있지만, 후자는 아직 바뀔 수 있는 개발 단계가 섞여 있습니다. LGTM은 이 표준을 대체하는 것이 아니라, 수집한 데이터를 저장하고 찾아보는 대표적인 오픈소스 백엔드 조합입니다.
한 번의 사용자 요청이 검색·모델·도구를 지나는 동안 텔레메트리가 전체 여정을 연결하는 모습. 이 글을 위해 새로 생성한 이미지입니다.
LLM 서비스는 왜 기존 모니터링만으로 부족할까
일반적인 웹 API는 요청 수, 오류율, CPU, 메모리와 응답 시간만으로도 많은 문제를 찾을 수 있습니다. LLM 시스템에도 이 지표들은 여전히 중요합니다. 하지만 LLM 애플리케이션은 보통 한 번의 요청 안에서 더 많은 단계를 거칩니다.
사용자가 “우리 회사 환불 규정을 알려줘”라고 물었다고 해보겠습니다. 서비스는 먼저 인증과 안전 정책을 확인하고, 질문을 임베딩으로 바꾸고, 벡터 데이터베이스에서 관련 문서를 찾고, 프롬프트를 조합하고, 모델을 호출합니다. 필요하면 사내 API나 외부 도구도 실행한 뒤 답변을 후처리합니다.
이때 화면에는 단지 “8초 걸림”이라고 표시될 수 있습니다. 그러나 운영자가 필요한 답은 훨씬 구체적입니다.
- 검색 단계가 5초를 썼는가?
- 모델이 첫 글자를 보내기까지 오래 기다렸는가?
- 도구 호출이 실패해 세 번 재시도했는가?
- 더 비싼 모델로 폴백되어 토큰 비용이 늘었는가?
- 답은 빨랐지만 관련 없는 문서를 근거로 삼았는가?
이 질문에 답하려면 사용자 요청 하나에 같은 trace_id를 붙이고, 그 안의 각 작업을 span으로 나눠야 합니다. Span은 여행 전체인 Trace 안에 기록된 “한 구간의 영수증”이라고 생각하면 쉽습니다. 시작 시각, 종료 시각, 성공 여부와 모델·도구 같은 속성을 함께 담습니다.
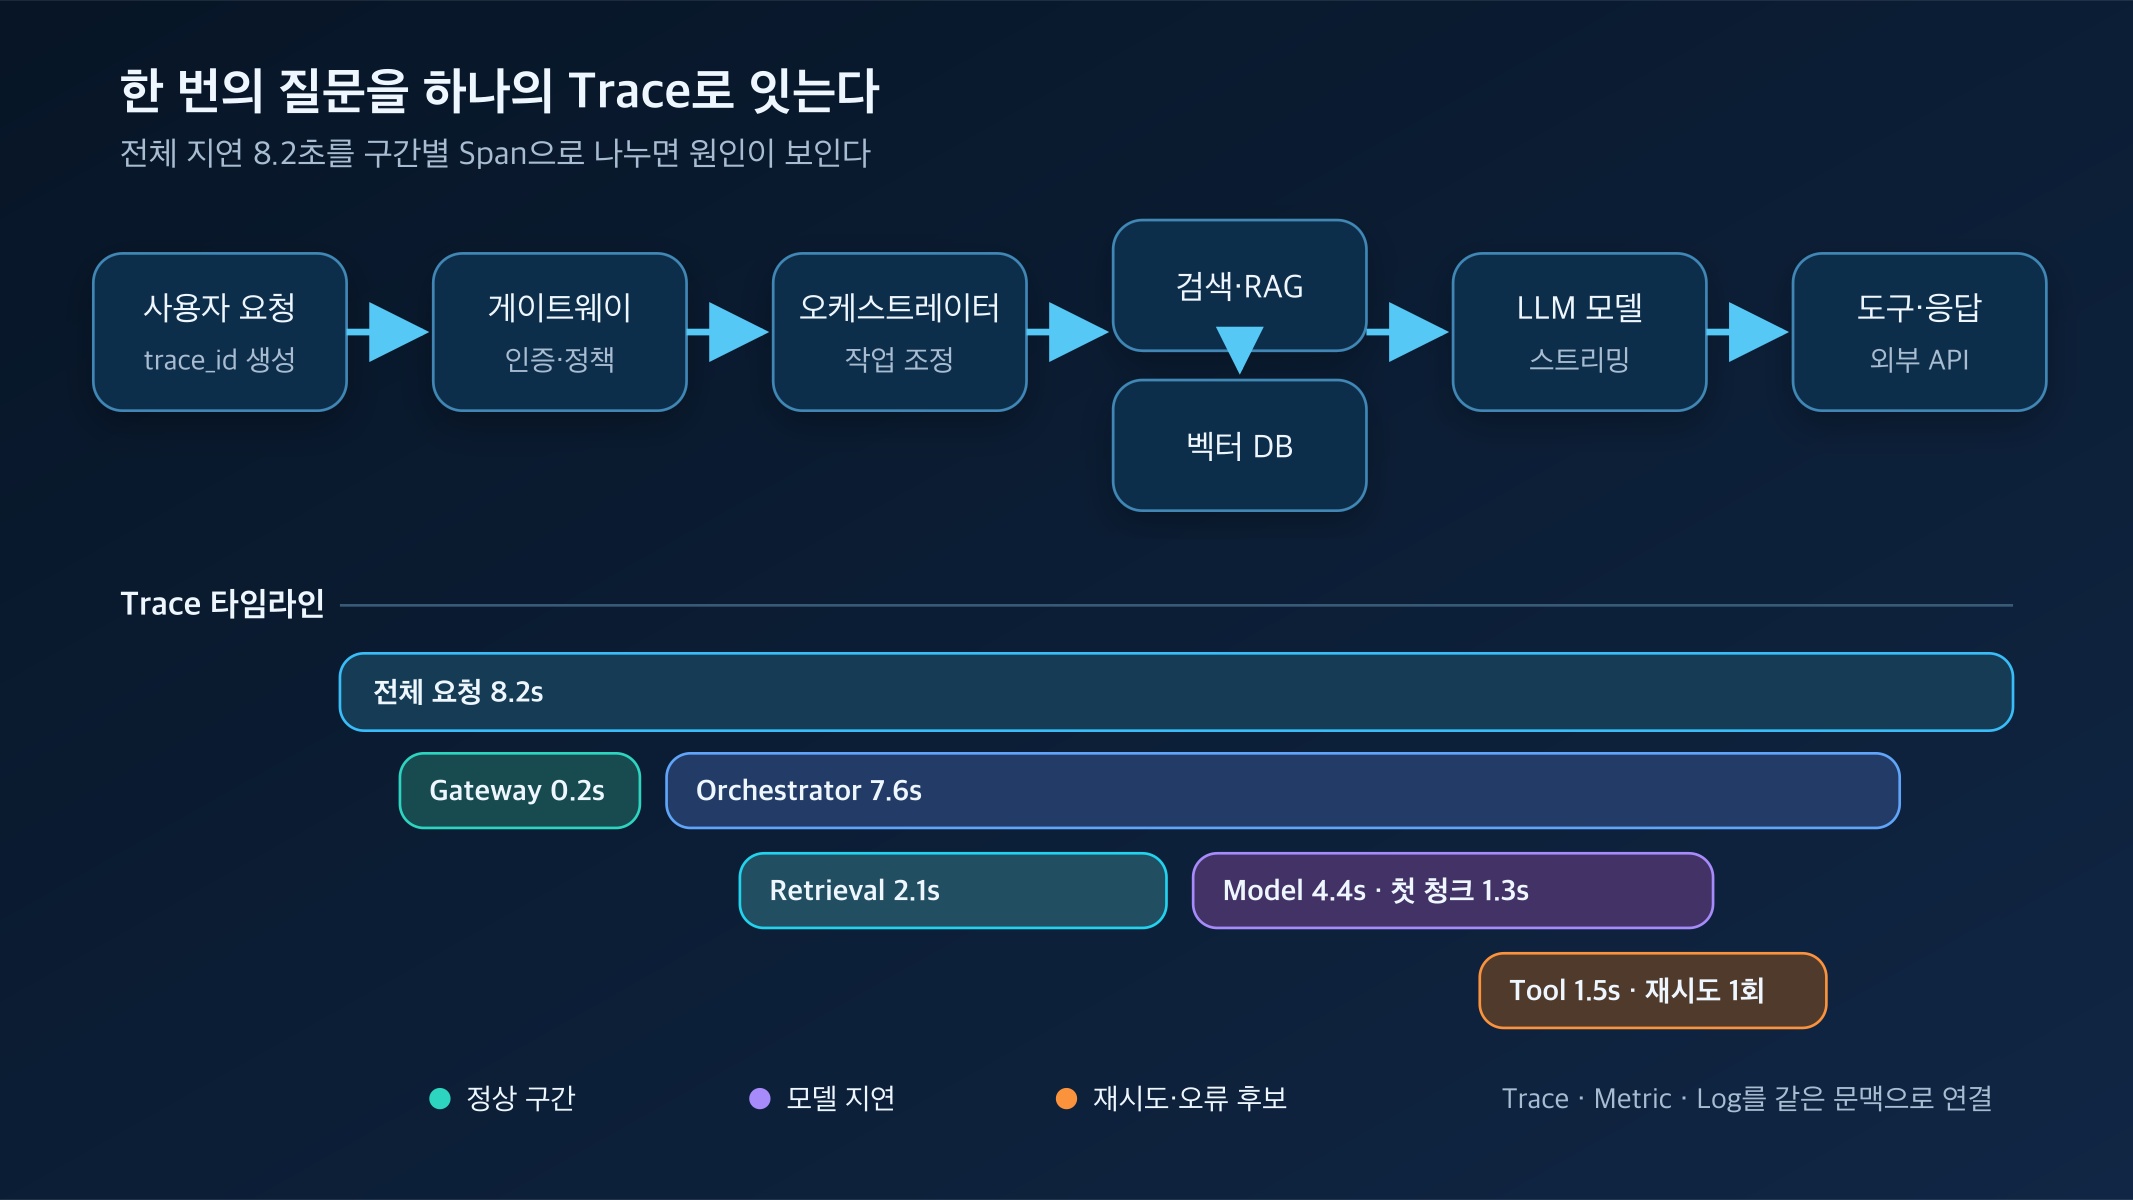
한 요청을 여러 Span으로 이어 보면 느린 구간과 실패 지점을 분리할 수 있습니다. OpenTelemetry의 Trace·Span 개념과 GenAI 규약을 바탕으로 재구성했습니다. 근거: OpenTelemetry Trace 개요, GenAI Span 규약
OTel이 해주는 일과 해주지 않는 일
OTel의 핵심 역할은 데이터를 보는 화면을 만드는 것이 아닙니다. 애플리케이션이 관측 데이터를 만들고, 같은 문맥으로 연결하고, 벤더 중립적인 방식으로 전달하도록 공통 언어를 제공하는 것입니다.
OTel은 주로 다음 신호와 연결 문맥을 다룹니다.
| 구성 요소 | 쉬운 뜻 | LLM 시스템에서 답하는 질문 |
| Trace | 요청 한 번의 전체 이동 경로 | 검색·모델·도구 중 어디에서 느려졌나? |
| Metric | 시간에 따라 집계한 숫자 | 오류율, P95 지연, 토큰 사용량이 얼마나 변했나? |
| Log | 특정 시점의 상세 기록 | 어떤 오류와 정책 결정이 발생했나? |
| Baggage·Context | 서비스 사이에 함께 전달되는 문맥 | 여러 프로세스의 기록을 같은 요청으로 어떻게 묶나? |
SDK나 자동 계측은 애플리케이션 안에서 데이터를 만듭니다. OTLP(OpenTelemetry Protocol)는 이 데이터를 보내는 공통 운반 규칙입니다. OpenTelemetry Collector는 데이터를 받아 배치하고, 민감한 속성을 걸러내고, 재시도한 뒤 하나 이상의 백엔드로 내보냅니다.
따라서 OTel만 설치한다고 대시보드와 장기 저장소가 생기지는 않습니다. OTel은 계측과 전달 계층이고, Tempo·Loki·Mimir 같은 제품은 저장과 조회 계층입니다. 이 경계를 분리하면 백엔드를 바꾸더라도 애플리케이션 계측 코드를 통째로 갈아엎을 가능성이 줄어듭니다.
LLM에서는 무엇을 관찰해야 할까
LLM 모니터링은 “모든 것을 기록하자”가 아니라, 장애와 비용과 품질을 설명할 최소 신호를 정하는 일입니다.
1. 엔드투엔드 지연과 첫 응답 시간
전체 응답 시간만 보면 스트리밍 서비스의 체감 속도를 놓칩니다. 사용자는 마지막 토큰이 도착한 시각보다 첫 토큰이나 첫 청크가 언제 보였는지에 더 민감할 수 있습니다. 그래서 전체 작업 시간과 함께 TTFT(Time to First Token) 또는 첫 청크까지의 시간을 분리해 봐야 합니다.
현재 GenAI 규약에는 작업 시간, 요청 모델, 응답 모델, 입력·출력 토큰과 스트리밍의 첫 청크 시간 등을 표현하는 속성과 메트릭이 정의되어 있습니다. 다만 실제 지원 범위는 언어와 계측 라이브러리마다 다르므로, 이름만 보고 수집된다고 가정하지 말고 샘플 Trace에서 확인해야 합니다.
2. 모델·공급자·폴백 경로
요청한 모델과 실제 응답한 모델이 다를 수 있습니다. 라우터가 장애나 한도 초과 때문에 다른 공급자 또는 더 비싼 모델로 넘겼을 수도 있습니다. Span에 작업 이름, 공급자, 요청 모델, 응답 모델과 오류 유형을 남기면 “성공률은 같지만 비용이 왜 늘었는가?”를 추적하기 쉬워집니다.
토큰 수는 비용을 추정하는 중요한 재료지만, 토큰 수 자체가 금액은 아닙니다. 공급자·모델·캐시 정책·계약에 따라 가격이 달라지므로 가격표와 계산 규칙은 별도의 버전 관리된 비용 계층에서 적용하는 편이 안전합니다.
3. RAG 검색과 도구 호출
좋지 않은 답변이 항상 모델 탓은 아닙니다. 검색 결과가 비어 있었거나, 오래된 문서를 가져왔거나, 도구가 잘못된 인수를 받았을 수 있습니다. RAG라면 검색 시간, 결과 수, 데이터 소스, 재순위화 단계와 선택된 문서 식별자를 연결하고, 도구 호출이라면 도구 이름, 지연, 성공 여부와 재시도 횟수를 기록합니다.
단, 원문 문서와 도구 인수·결과를 무조건 일반 Trace 저장소에 넣어서는 안 됩니다. 개인정보, 사내 비밀과 인증 정보가 섞일 수 있기 때문입니다. 운영 환경에서는 내용 대신 접근 통제가 분리된 저장소의 참조값이나 비식별 식별자를 남기는 방식이 더 적합합니다.
4. 품질과 안전성
OTel은 “이 작업이 언제, 어디서, 얼마나 걸려 실행되었는가?”를 연결하는 데 강합니다. 반면 “답변이 사실인가?”, “근거와 일치하는가?”, “사용자에게 유용한가?”는 애플리케이션별 평가 기준이 필요합니다.
따라서 관측성과 평가(Evaluation)를 같은 것으로 취급하지 않는 것이 좋습니다. 온라인 피드백, 오프라인 정답 세트, 근거성·관련성 평가와 안전성 검사를 별도로 운영하되, 평가 결과를 Trace 또는 대화 식별자와 연결하면 “품질이 떨어진 요청이 어떤 실행 경로를 거쳤는가?”까지 조사할 수 있습니다. OTel은 품질 평가 엔진이 아니라 서로 다른 증거를 연결하는 척추에 가깝습니다.
그래서 OTel은 요즘 표준이 맞을까
짧게 답하면 관측 데이터의 계측·문맥 전파·전달 기반으로는 맞습니다. OpenTelemetry는 OpenTracing과 OpenCensus의 흐름을 통합해 성장했고, 2026년 5월 CNCF Graduated 프로젝트가 되었습니다. 주요 언어의 Trace와 Metric API·SDK도 대체로 Stable 상태이며, OTLP와 Collector를 지원하는 오픈소스·상용 백엔드가 넓게 형성되어 있습니다.
하지만 “OTel의 모든 기능과 모든 속성 이름이 영구 고정됐다”는 뜻은 아닙니다.
- 언어별 로그 신호의 성숙도는 서로 다릅니다.
- Collector는 구성요소마다 안정성 수준이 다른 Mixed 상태입니다.
- LLM·에이전트용 GenAI Semantic Conventions는 별도 저장소로 분리되어 발전 중이며, Span·Event 문서에는 Development 상태가 남아 있습니다.
- 실제 계측 라이브러리마다 지원하는 공급자와 속성 범위가 다릅니다.
그래서 실무 결론은 두 문장입니다. 새 LLM 플랫폼의 공통 계측·전달 규격은 OTel/OTLP로 잡아도 좋습니다. 다만 gen_ai.* 속성은 사용하는 규약 버전과 라이브러리를 고정하고, 내부 데이터 모델과 대시보드 사이에 얇은 변환 계층을 둬 변경에 대비해야 합니다.
LGTM은 OTel과 어떤 관계일까
LGTM은 Loki, Grafana, Tempo, Mimir의 머리글자를 합친 이름입니다.
- Loki는 로그를 저장하고 조회합니다.
- Grafana는 여러 데이터 소스를 탐색하고 시각화합니다.
- Tempo는 분산 Trace를 저장하고 조회합니다.
- Mimir는 Prometheus 호환 메트릭을 장기 저장합니다.
즉 LGTM은 텔레메트리의 의미와 전송 방식을 정하는 산업 표준이 아닙니다. OTel로 만든 데이터를 받아 운영하기 좋은 Grafana 생태계의 백엔드 조합입니다. OpenSearch, Elastic, Jaeger, Prometheus, 클라우드 관리형 서비스나 상용 관측성 플랫폼을 선택해도 OTel 계층은 그대로 유지할 수 있습니다.
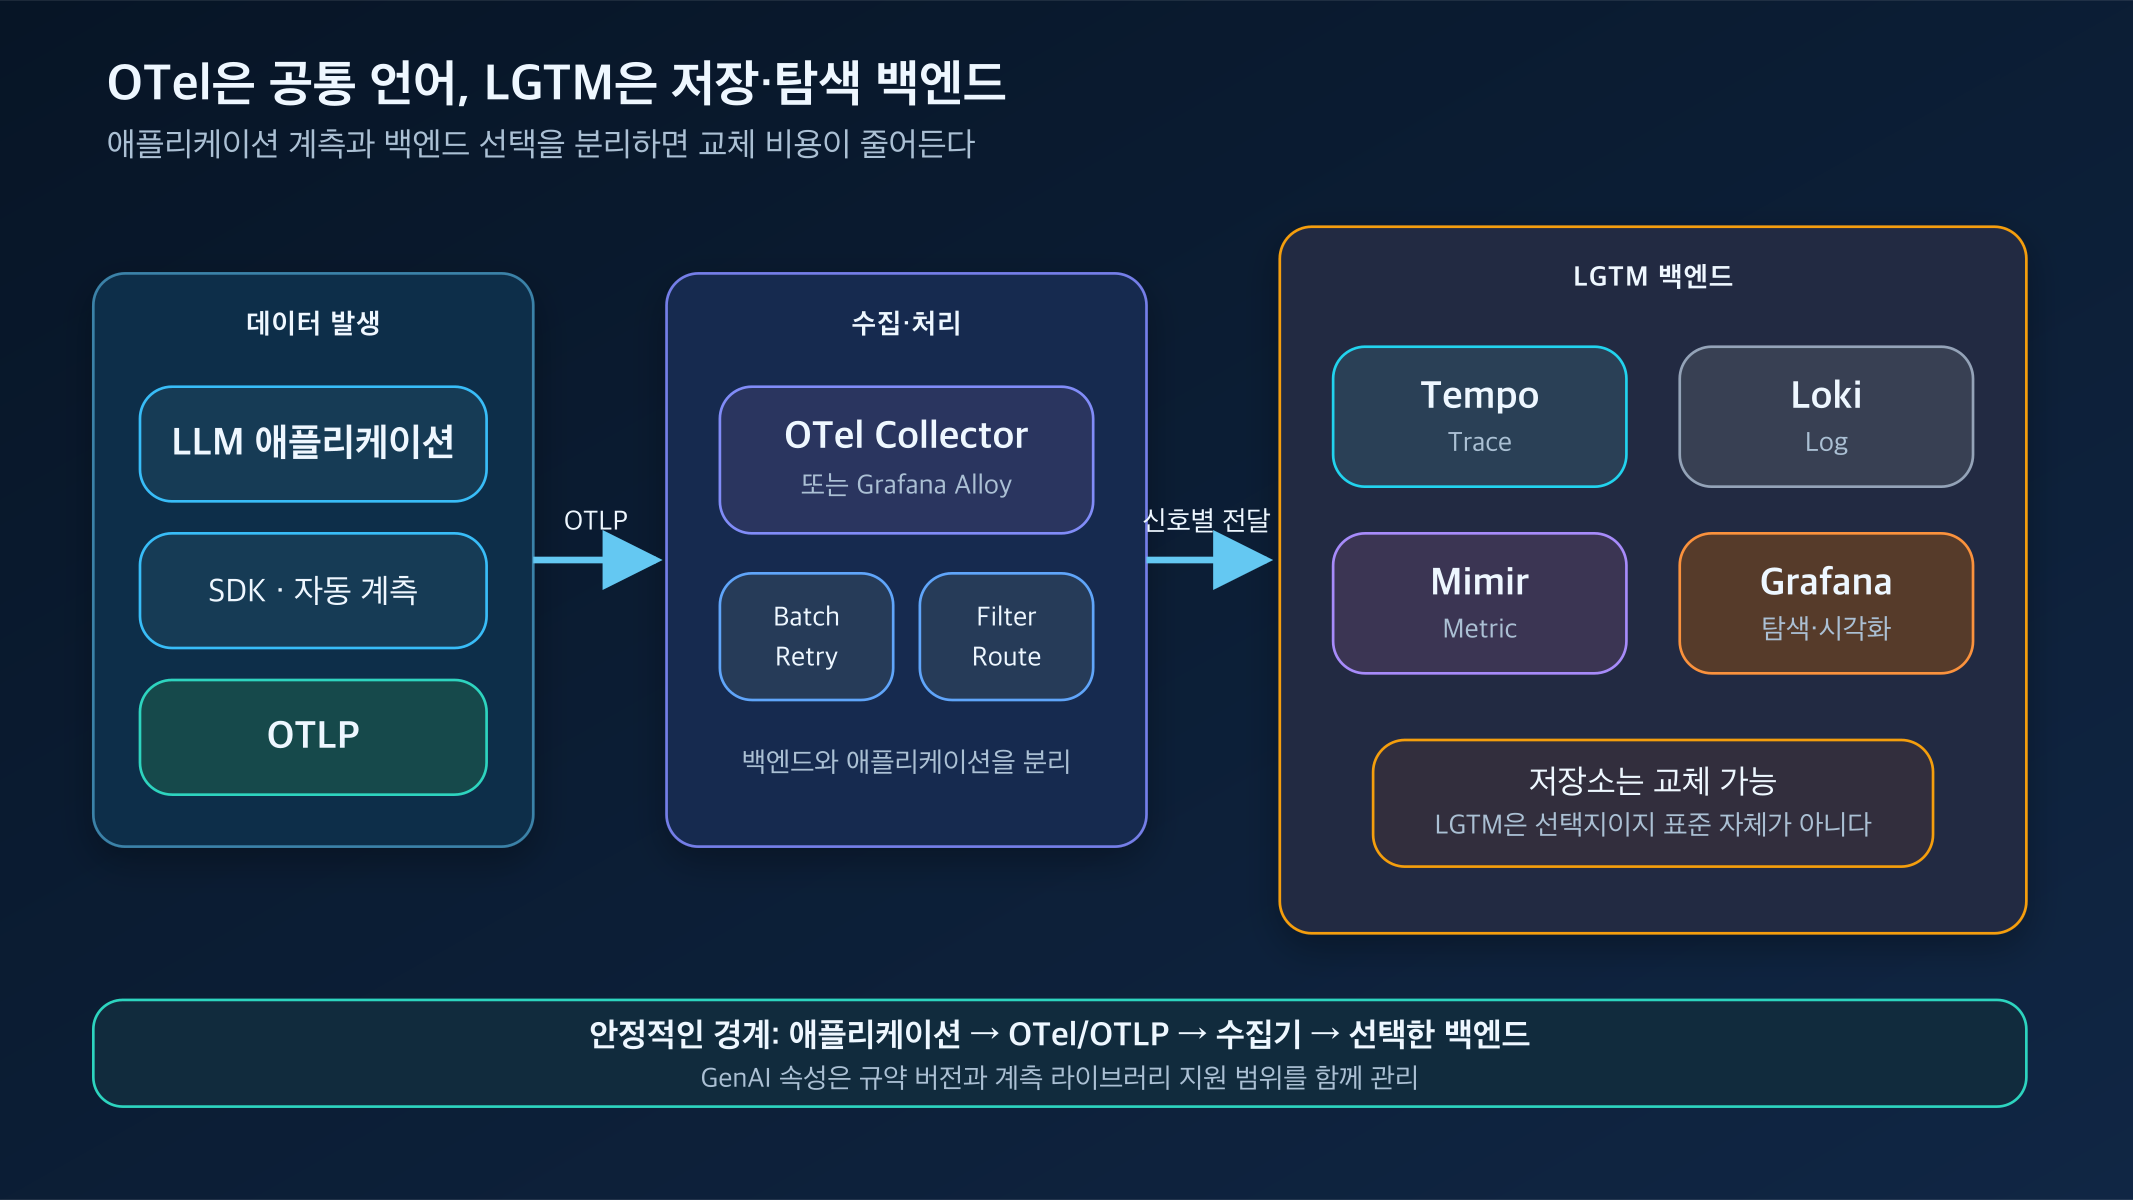
애플리케이션은 OTLP로 Collector 또는 Alloy에 보내고, LGTM은 신호별 저장·조회 역할을 맡습니다. Grafana 공식 문서를 바탕으로 재구성했습니다. 근거: Grafana Alloy 동작 방식, Docker OpenTelemetry LGTM
수집 계층에서는 순정 OpenTelemetry Collector를 쓸 수도 있고 Grafana Alloy를 쓸 수도 있습니다. Alloy는 OpenTelemetry Collector와 호환되는 수집 파이프라인과 Prometheus·Loki 생태계 기능을 함께 제공합니다. Grafana 중심으로 운영한다면 자연스러운 선택이지만, 이것 역시 OTel의 필수 구성 요소는 아닙니다.
개발·데모 환경에서는 Grafana가 제공하는 docker-otel-lgtm 이미지로 Collector, Grafana, Loki, Mimir, Tempo를 한 번에 시험할 수 있습니다. 공식 문서도 이 이미지를 개발·데모·테스트용으로 설명하므로, 그 구성을 그대로 대규모 운영 환경의 정답으로 복사해서는 안 됩니다.
실무에서는 어떤 순서로 시작해야 할까
처음부터 모든 프롬프트와 모든 Span을 저장하면 비용과 보안 문제부터 만납니다. 다음처럼 작은 수직 조각으로 시작하는 편이 좋습니다.
- 서비스 경계를 먼저 연결합니다. API Gateway, LLM Orchestrator, Retriever, Model Client와 Tool Runner에 같은 Trace 문맥이 전달되는지 확인합니다.
- 운영 질문을 정합니다. P95 전체 지연, 첫 응답 시간, 모델·공급자별 오류율, 입력·출력 토큰, 폴백률, 검색·도구 실패율처럼 실제로 행동을 바꿀 지표부터 고릅니다.
- OTLP 출구를 하나로 모읍니다. 애플리케이션이 백엔드 주소를 직접 알게 하기보다 Collector나 Alloy가 배치·재시도·필터링·라우팅을 맡게 합니다.
- LGTM 또는 다른 백엔드에 연결합니다. Trace에서 관련 로그와 메트릭으로 이동할 수 있도록 trace_id, 서비스 이름과 환경 속성을 일관되게 유지합니다.
- 실제 실패로 검증합니다. 모델 시간 초과, 검색 지연, 도구 오류와 폴백을 일부러 발생시켜 어느 Span에서 보이는지 확인합니다.
- 그다음 품질 평가를 연결합니다. 낮은 사용자 평가나 근거성 실패가 발생한 요청을 Trace로 되짚을 수 있게 만듭니다.
대시보드는 “있는 데이터를 모두 그리는 곳”이 아니라 운영 결정을 빠르게 만드는 화면이어야 합니다. 예를 들어 첫 화면에는 사용자 체감 지연, 오류율, 토큰 사용량과 폴백률을 두고, 이상이 생겼을 때 Trace로 내려가 검색·모델·도구 중 원인을 찾는 구조가 실용적입니다.
반드시 먼저 정해야 할 보안과 비용 경계
LLM 텔레메트리는 일반 웹 로그보다 민감할 수 있습니다. 프롬프트에는 이름, 이메일, 계약 정보와 소스 코드가 들어갈 수 있고, 모델 응답이나 도구 결과에는 내부 데이터가 포함될 수 있습니다.
OpenTelemetry의 GenAI 문서도 시스템 지시문, 입력 메시지와 출력 메시지를 민감하고 큰 데이터로 보고 기본적으로 수집하지 말 것을 권합니다. 필요한 경우에만 명시적으로 켜고, 운영 환경에서는 별도 저장소에 내용을 보관한 뒤 Span에는 참조를 남기는 방식을 제시합니다.
다음 원칙은 도입 전에 정책으로 고정하는 것이 좋습니다.
- 프롬프트와 응답 본문은 기본 수집하지 않습니다.
- 개인정보와 인증 정보는 SDK 또는 Collector에서 제거합니다.
- 모델·사용자 ID처럼 카디널리티가 큰 값은 Metric Label로 무분별하게 쓰지 않습니다.
- 정상 요청은 샘플링하되 오류, 높은 지연과 중요한 평가 실패는 보존하는 정책을 검토합니다.
- Trace 저장소와 원문 저장소의 접근 권한·보존 기간을 분리합니다.
- 텔레메트리 유실과 Collector 자체 장애도 별도 메트릭으로 감시합니다.
마무리
LLM 시스템의 장애는 모델 호출 한 줄에서만 생기지 않습니다. 검색, 라우팅, 안전 정책, 도구와 외부 API가 한 답변을 함께 만들기 때문에, 운영자는 이 전체 여정을 하나의 요청으로 볼 수 있어야 합니다.
OTel은 그 여정을 공통 언어로 연결하는 현재의 가장 안전한 기반 선택입니다. LGTM은 그 데이터를 오픈소스로 저장하고 탐색하려 할 때 잘 맞는 대표 조합입니다. 다만 핵심 OTel의 성숙함을 GenAI 전용 규약의 완전한 안정화로 확대 해석해서는 안 됩니다.
가장 현실적인 출발점은 OTel/OTLP를 플랫폼의 경계로 정하고, LLM 전용 속성은 버전을 관리하며, 프롬프트 본문은 기본적으로 수집하지 않는 것입니다. 이 세 가지를 지키면 특정 모델 공급자나 관측성 백엔드를 바꾸더라도 다시 쓸 수 있는 모니터링 기반을 만들 수 있습니다.
참고한 공식 자료
'클라우드 > opentelemetry' 카테고리의 다른 글
| 관측 시스템 조립하기: LLM 보안 관측 스택 (0) | 2026.09.03 |
|---|---|
| 신호를 전달하는 길: OpenTelemetry와 Grafana Alloy (0) | 2026.09.03 |
| 세 가지 보안 신호: Log·Trace·Metric을 연결해야 사고가 보인다 (0) | 2026.09.03 |
| 💥 OpenTelemetry 예외 처리, 이거 모르면 큰일납니다! (성능과 안정성 둘 다 잡는 비법) (0) | 2025.11.11 |
| OpenTelemetry 메트릭, CUMULATIVE vs DELTA 헷갈리면 큰일나는 이유 🚨 (1) | 2025.11.11 |


