관측 시스템이 아무리 많은 Log·Trace·Metric을 모아도 사람이 대시보드를 계속 지켜봐야 한다면 위험을 먼저 알릴 수 없다. Alert는 관측값이 정한 조건을 만족했음을 알리는 상태이고, Notification은 그 Alert를 이메일·메신저·호출 시스템 같은 수신처로 전달한 결과다. 둘을 구분해야 “조건을 탐지하는 책임”과 “누구에게 언제 알릴지 결정하는 책임”을 나눌 수 있다.
이번 글에서는 LLM 보안 관측 스택에 경보를 붙인다. Prometheus가 차단률과 오류율을 평가하고, Alertmanager가 중복 제거·그룹화·라우팅·Silence·Inhibition을 수행하며, Grafana가 경보 상태와 관련 Metric·Log·Trace를 조사하는 화면을 제공하는 흐름이다. Grafana-managed Alerting을 쓰는 대안도 함께 구분한다.
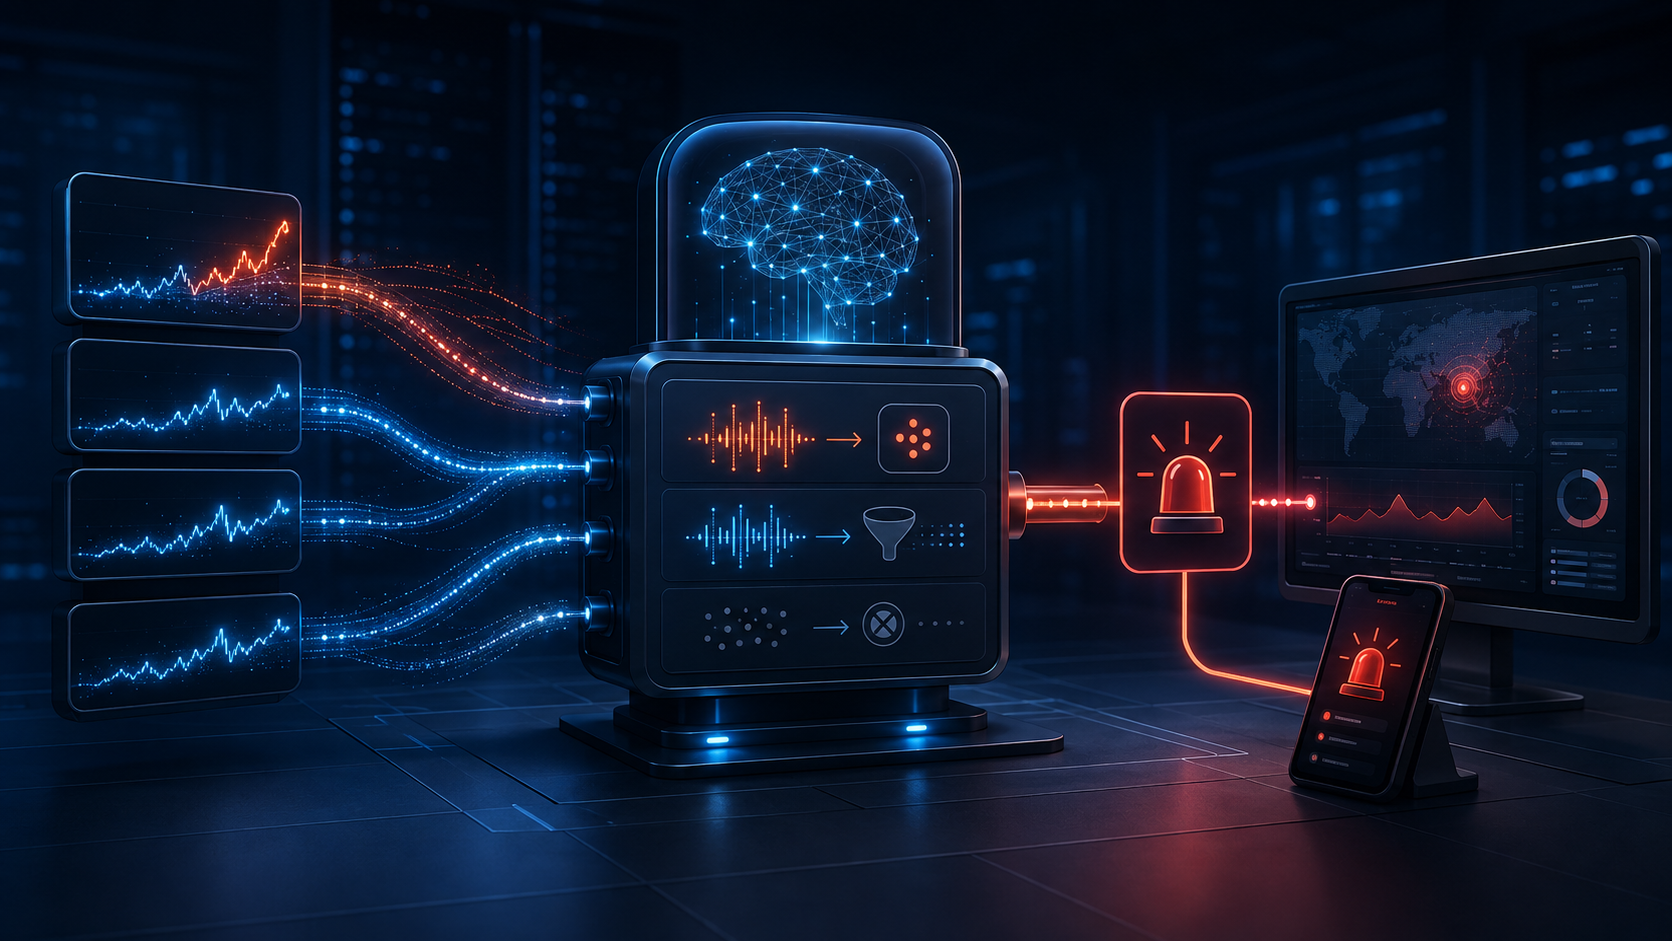
경보 파이프라인의 책임을 먼저 나누자
Prometheus Alerting Rule은 PromQL 표현식을 일정 간격으로 평가한다. 조건이 잠깐 참이 됐다고 바로 사람을 깨우지 않도록 for 기간을 둘 수 있다. Alertmanager는 Prometheus 같은 Client가 보낸 Alert를 받아 같은 사건을 묶고, 이미 보낸 알림을 중복 제거하며, Label에 따라 Receiver로 보낸다.
Grafana는 두 역할을 가질 수 있다. 하나는 Prometheus·Alertmanager의 상태를 시각화하고 관련 데이터로 이동하는 관측 화면이다. 다른 하나는 Grafana-managed Alert Rule을 직접 평가하고 내장 Grafana Alertmanager로 Notification Policy와 Contact Point를 운영하는 경보 플랫폼이다. 한 환경에서 두 방식을 무심코 섞으면 같은 조건이 두 번 평가되어 중복 알림이 생길 수 있다.
| 구성 | 규칙 평가 | 알림 라우팅 | 적합한 경우 |
| Prometheus + 외부 Alertmanager | Prometheus | Alertmanager | Prometheus 중심, 규칙을 파일·Git으로 관리 |
| Grafana-managed Alerting | Grafana | 기본 Grafana Alertmanager 또는 지원되는 외부 Alertmanager | 여러 데이터 소스의 Query·Expression을 한 화면에서 관리 |
| 혼합 운영 | 규칙별로 명시 | 경로별로 명시 | 기존 Prometheus 규칙을 유지하며 일부 다중 데이터 소스 경보를 추가 |
이 글의 실습은 첫 번째 구조를 기본으로 한다. Grafana는 조회와 조사에 집중시킨다.
LLM 보안 경보는 무엇을 울려야 할까
모든 차단을 긴급 호출로 만들면 정상 방어 활동만으로도 Alert Fatigue가 생긴다. 먼저 “사람이 지금 개입하지 않으면 피해가 커지는가?”를 묻는다.
| 신호 | 권장 처리 예 | 이유 |
| 프롬프트 인젝션 차단 1건 | 대시보드·Log 기록 | 정상적인 방어 성공일 수 있음 |
| 차단률이 기준선보다 지속 증가 | 경고 채널 | 자동화 공격 또는 정책 오탐 가능 |
| 차단 뒤 도구 호출 발생 | 긴급 호출 후보 | Guardrail 우회 또는 제어 흐름 결함 가능 |
| 관측 파이프라인 수집 중단 | 별도 운영 경보 | “공격이 없음”과 “보이지 않음”을 구분해야 함 |
예시는 고정된 보안 표준 수치가 아니다. 트래픽 규모와 정상 기준선을 측정한 뒤 조직 상황에 맞게 임계값을 정해야 한다.
1단계: Prometheus Alerting Rule 만들기
다음은 10분 동안 LLM 요청 중 차단 비율이 30%를 넘는 상태가 5분 지속될 때 Alert를 만드는 실습 예다. 실제 Metric 이름은 계측 코드에 맞춘다.
groups:
  - name: llm-security
    interval: 30s
    rules:
      - alert: LlmSecurityBlockRateHigh
        expr: |
          sum(rate(llm_security_requests_total{decision="block"}[10m]))
          /
          sum(rate(llm_security_requests_total[10m]))
          > 0.30
        for: 5m
        labels:
          severity: warning
          service: llm-security-app
          team: ai-security
        annotations:
          summary: "LLM 보안 차단률이 지속적으로 높습니다"
          description: "대시보드에서 규칙별 증가와 관련 Trace를 확인하세요."
Label은 Alert Instance를 식별하고 Routing·Silence에 사용된다. severity, service, team처럼 안정적이고 제한된 값을 넣는다. Annotation은 대응자가 이해할 설명과 Runbook URL에 적합하다. 프롬프트 원문, 사용자 입력, 토큰이나 개인정보를 Label·Annotation에 넣지 않는다. 알림은 외부 메신저로 전달될 수 있기 때문이다.
문법과 규칙 파일 로딩 여부를 먼저 검증한다.
promtool check rules llm-security-alerts.yml
curl -s http://localhost:9090/api/v1/rules
for는 잡음을 줄이지만 탐지 지연도 만든다. 치명적인 “차단 후 도구 실행”은 짧거나 없는 Pending Period가 필요할 수 있고, 일시적인 차단률 증가는 더 긴 기간이 적합하다.
2단계: Alertmanager에서 묶고 보낼 곳 정하기
Alertmanager의 Route는 Label Matcher를 따라 내려가는 Tree다. 최상위 Route는 모든 Alert를 받고, 하위 Route가 team과 severity에 따라 Receiver를 선택한다.
route:
  receiver: default-receiver
  group_by: [alertname, service, team]
  group_wait: 30s
  group_interval: 5m
  repeat_interval: 4h
  routes:
    - receiver: ai-security-urgent
      matchers:
        - team="ai-security"
        - severity="critical"
    - receiver: ai-security-warning
      matchers:
        - team="ai-security"
        - severity="warning"

receivers:
  - name: default-receiver
  - name: ai-security-urgent
  - name: ai-security-warning
예제 Receiver에는 실제 Webhook·메일 자격증명을 넣지 않았다. Secret은 별도 Secret Manager나 런타임 파일로 주입하고, 저장소와 블로그·알림 본문에 남기지 않는다.
세 시간 옵션은 서로 다르다.
- group_wait: 새 그룹의 첫 Notification을 보내기 전 기다리는 시간
- group_interval: 이미 알린 그룹에 새 Alert가 추가됐을 때 다음 알림까지의 간격
- repeat_interval: 같은 Firing Alert를 다시 알리는 간격
group_by에 사용자 ID·RequestId·TraceId를 넣으면 사실상 모든 Alert가 별도 그룹이 되어 알림 폭주를 만들 수 있다. 긴급 조사에 필요한 TraceId는 Annotation이나 Grafana 링크에서 제한적으로 전달하되 민감정보 여부와 접근 권한을 확인한다.
Grouping·Silence·Inhibition은 서로 다르다
Grouping은 여러 Alert를 한 Notification으로 묶는다. Silence는 Matcher에 맞는 Alert 알림을 정해진 시간 동안 멈춘다. 점검 작업처럼 의도한 변경에 사용한다. Inhibition은 더 큰 원인 Alert가 Firing 중일 때 그 결과로 발생한 하위 Alert 알림을 억제한다.
예를 들어 ObservabilityPipelineDown이 발생하면 “LLM Metric 없음” 같은 하위 Alert 수십 개를 Inhibit할 수 있다. 다만 잘못된 Inhibition은 중요한 보안 신호까지 숨긴다. Source·Target Matcher와 equal Label을 좁게 설계하고 테스트해야 한다.
Silence는 Alert를 해결하지 않는다. Notification만 억제하므로 종료 시각, 작성자, 변경 작업과 근거를 남긴다. 무기한 Silence는 장애를 조용히 만드는 스위치가 될 수 있다.
3단계: Grafana에서 경보를 조사 경로로 바꾸기
좋은 Notification은 결론을 과장하지 않고 다음 행동으로 안내한다.
무엇: LlmSecurityBlockRateHigh
어디: service=llm-security-app, environment=production
심각도: warning
언제부터: StartsAt
다음 행동: 차단 규칙별 Metric → 차단 Trace → 같은 TraceId의 Log
Runbook: 접근통제가 적용된 내부 URL
Grafana Dashboard에는 전체 요청률, 차단률, 규칙별 증가량과 도구 호출 수를 둔다. Alert Annotation이나 Notification Template에는 시간 범위와 서비스 Label을 포함한 Grafana 링크를 넣을 수 있다. 링크를 받은 사용자가 해당 Tenant의 Loki·Tempo·Prometheus를 볼 권한이 있는지는 각 데이터 소스와 Gateway가 다시 검사해야 한다.
Grafana Alerting을 사용할 때는 Alert Rule의 Evaluation Interval, Pending Period, Keep Firing For를 구분한다. Pending은 조건이 일정 시간 지속되는지 확인하고, Keep Firing For는 조건이 잠시 정상으로 돌아왔을 때 Firing·Resolved가 반복되는 Flapping을 줄인다. No Data와 Error도 정상으로 취급할지 별도 Alert로 만들지 명시해야 한다.
4단계: 안전한 합성 경보로 끝까지 시험하기
운영 Receiver에 곧바로 시험 알림을 보내지 않는다. 먼저 로컬 Webhook Receiver나 테스트 채널을 사용한다. Prometheus 식을 잠시 안전한 합성 Metric에 연결하거나, Alertmanager API에 실제 개인정보가 없는 테스트 Alert를 보낸다.
검증 항목은 다음과 같다.
- Pending에서 Firing으로 예상 시간에 전환되는가
- 같은 alertname, service, team Alert가 한 Notification으로 묶이는가
- Warning과 Critical이 서로 다른 Receiver로 가는가
- Silence가 Matcher와 종료 시각에 맞게 동작하는가
- 상위 장애 Alert가 하위 증상만 Inhibit하는가
- Resolved Notification이 필요한 수신처에 전달되는가
- Notification에 프롬프트·응답·개인정보·Secret이 없는가
- Dashboard에서 Loki·Tempo·Prometheus 조사 경로가 열리는가
운영에서 놓치기 쉬운 경계
Alertmanager 자체도 장애 날 수 있다. 고가용성 구성에서는 Prometheus가 모든 Alertmanager Instance에 직접 Alert를 보내도록 공식 문서를 확인해야 한다. 단순 Load Balancer 하나만 가리키는 구성은 권장 동작과 다르다. 네트워크 분할 상황에서는 놓친 알림보다 일부 중복을 택하는 특성도 대응 절차에 반영한다.
또한 Notification Channel은 새로운 데이터 유출 경로다. 외부 SaaS로 보내는 Label·Annotation을 최소화하고, Webhook 서명·TLS·수신처 Allowlist·Secret 회전·전송 실패 Metric을 운영한다. 경보 설정 변경 권한과 Silence 생성 권한도 분리하고 감사 Log를 남긴다.
마무리
좋은 경보 시스템은 많이 울리는 시스템이 아니다. Prometheus나 Grafana가 조건을 안정적으로 평가하고, Alertmanager가 관련 사건을 묶어 올바른 팀에 전달하며, Grafana가 Metric에서 Trace와 Log로 이어지는 조사 문맥을 제공해야 한다.
LLM 보안에서는 단일 차단보다 지속적인 비율 변화, 차단 이후의 위험한 실행, 관측 공백에 우선순위를 둔다. Label은 Routing에 필요한 최소 문맥만 담고, 상세 원문과 개인정보는 Notification에서 제외한다. 탐지·라우팅·조사의 책임을 나누면 경보는 소음이 아니라 대응을 시작시키는 신뢰할 수 있는 신호가 된다.
공식 자료
- Prometheus Alertmanager 개념
- Alertmanager 설정과 Route
- Alertmanager 고가용성
- Grafana Alerting 개요
- Grafana Alert Rule 평가
- Grafana Alert Label과 Annotation
- Grafana Notification Policy
※ 경보 임계값, Receiver와 화면 이름은 환경과 제품 버전에 따라 달라진다. 운영 적용 전 공식 문서와 현재 설치 버전을 확인하고 테스트 Receiver에서 먼저 검증하자.
카테고리: 클라우드/prometheus
태그: Alertmanager, Grafana Alerting, Prometheus, LLM Security, Alert, Monitoring, Observability, Incident Response
'클라우드 > prometheus' 카테고리의 다른 글
| 차단 한 줄 너머: Log·Trace·Metric·Alert로 재구성하는 LLM 연속 공격 (0) | 2026.09.03 |
|---|---|
| 공격의 흔적 따라가기: Loki·Tempo·Prometheus (0) | 2026.09.03 |
| 📈 당신의 모니터링 시스템을 위협하는 보이지 않는 적, '카디널리티' (0) | 2025.10.13 |
| ☁️ 클라우드 네이티브의 심장, CNCF가 꿈꾸는 상생의 생태계 (0) | 2025.10.13 |
| ✨ 프로메테우스의 숨은 보석, honor_labels 파헤치기 (0) | 2025.10.12 |


