Amazon Bedrock(아마존 베드락)은 여러 회사의 파운데이션 모델을 AWS 안에서 API로 골라 쓰게 해주는 완전관리형 생성형 AI 서비스입니다. 쉽게 말하면 직접 GPU 서버를 사고, 모델을 내려받고, 추론 서버를 운영하는 대신 필요한 모델에 요청을 보내고 사용량만큼 비용을 내는 방식입니다.
여기서 가장 중요한 오해부터 풀어야 합니다. Bedrock이 GPU를 사용하지 않는 것은 아닙니다. 모델 뒤에서는 GPU나 AWS의 AI 가속기가 동작할 수 있습니다. 다만 사용자가 EC2 GPU 인스턴스를 고르고, CUDA와 드라이버를 맞추고, 모델을 배포하고, 오토스케일링을 운영하지 않아도 됩니다. GPU를 없앤 것이 아니라 GPU 운영을 AWS의 관리 영역으로 옮긴 것입니다.
이 글에서는 Bedrock의 등장 배경과 역사부터 모델 종류, 요청 흐름, 비용, 보안, RAG·에이전트, SageMaker AI와의 차이, 실제 도입 기준까지 한 번에 정리합니다.
1. Bedrock은 왜 등장했을까
생성형 AI 애플리케이션을 직접 운영하려면 생각보다 많은 일이 필요합니다. GPU 인스턴스를 확보하고, 모델 가중치를 저장하고, 추론 프레임워크와 드라이버 버전을 맞추고, 트래픽에 따라 복제본을 늘려야 합니다. 모델을 바꾸면 입력 형식과 운영 방식도 다시 검토해야 합니다.
반대로 외부 모델 회사의 API만 바로 사용하면 시작은 빠르지만, AWS의 IAM 권한, CloudTrail 감사, 네트워크 경계와 기존 애플리케이션 운영 체계 안에 통합하는 작업이 남습니다. 여러 모델을 비교하거나 교체할 때 공급자별 API 차이도 커집니다.
Bedrock은 이 둘 사이를 메우기 위해 나왔습니다. AWS는 2023년 4월 Bedrock을 처음 공개했고, 2023년 9월 28일 정식 출시했습니다. 당시 핵심은 Amazon뿐 아니라 Anthropic, AI21 Labs, Cohere, Stability AI 같은 여러 공급자의 모델을 하나의 완전관리형 서비스에서 제공하는 것이었습니다. AWS의 Bedrock 정식 출시 발표
이후 Bedrock은 단순한 “모델 호출 API”에서 생성형 AI 애플리케이션 플랫폼으로 넓어졌습니다.
- 2023년: Bedrock 정식 출시, Agents와 Knowledge Bases 등 애플리케이션 기능 확대
- 2024년 4월: Guardrails와 Model Evaluation 정식 출시
- 2024년 12월: Amazon Nova 모델군과 100개 이상의 전문 모델을 연결하는 Bedrock Marketplace 발표
- 2025년 이후: 멀티모달 가드레일, 자동 추론 검사, 모델 선택·평가·커스터마이징, AgentCore를 포함한 에이전트 운영 기능 확장
이 역사는 Bedrock의 정체를 잘 보여줍니다. 처음에는 “여러 모델을 서버리스 API로 호출하는 서비스”였다면, 지금은 모델·데이터·안전장치·평가·에이전트 운영을 AWS의 권한과 감사 체계 안에서 묶는 플랫폼에 가깝습니다. Guardrails 정식 출시, Amazon Nova 발표, Bedrock Marketplace 발표
2. “GPU 없이 쓴다”는 말의 정확한 의미
Bedrock의 서버리스는 Lambda처럼 코드를 실행한다는 뜻이 아니라, 모델 추론에 필요한 인프라를 사용자가 직접 프로비저닝하지 않는다는 뜻입니다. 애플리케이션은 HTTPS API를 호출하고, AWS가 뒤쪽의 용량 배치와 확장을 담당합니다.
직접 호스팅과 비교하면 사라지는 일이 분명합니다.
이 장점은 특히 PoC와 변동 트래픽에서 큽니다. 하루에 몇 번만 호출하는 내부 요약 도구를 위해 24시간 GPU를 켜둘 필요가 없습니다. 여러 모델을 짧게 평가할 때도 각각의 추론 서버를 만들지 않아도 됩니다.
하지만 서버리스가 무제한을 뜻하지는 않습니다. 계정과 모델별 할당량, 분당 처리량, 리전 가용성, 일시적인 스로틀링은 여전히 고려해야 합니다. 예측 가능한 전용 처리량이 필요하면 시간당 고정 비용의 Provisioned Throughput을 선택할 수 있습니다. Bedrock Provisioned Throughput 문서
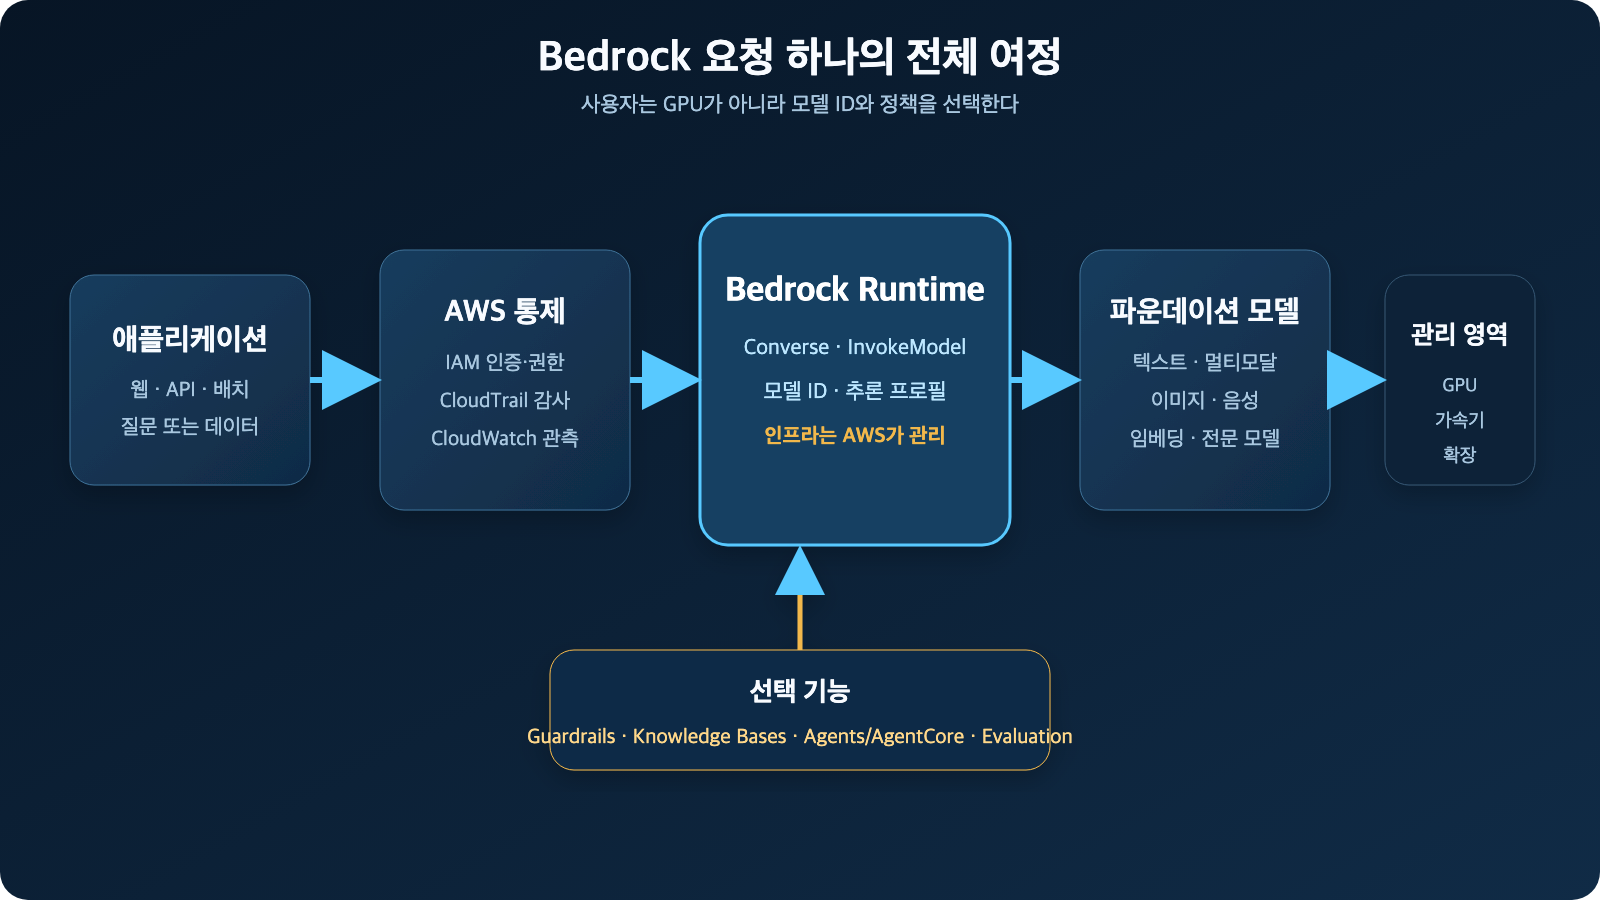
그림 1. Bedrock의 요청 경로. GPU와 추론 서버는 사라진 것이 아니라 AWS 관리 영역 뒤에 있다. AWS Bedrock 정식 출시 설명과 Bedrock API 문서를 바탕으로 재구성.
3. 요청 하나가 처리되는 순서
Bedrock을 이해하는 가장 빠른 방법은 요청 하나를 따라가는 것입니다.
- 사용자가 웹이나 업무 시스템에 질문을 입력합니다.
- 애플리케이션은 IAM 역할 또는 AWS 자격 증명으로 Bedrock Runtime API를 호출합니다.
- 필요하면 Guardrails가 입력에서 금지 주제, 유해 콘텐츠, 프롬프트 공격, 개인정보를 검사합니다.
- 애플리케이션이 Knowledge Bases를 사용한다면 질문과 관련된 사내 문서를 검색해 컨텍스트를 만듭니다.
- 지정한 모델 또는 추론 프로필이 입력을 처리합니다.
- Guardrails를 적용했다면 모델 출력도 다시 검사하거나 민감정보를 마스킹합니다.
- 애플리케이션은 결과와 사용량 정보를 받아 사용자에게 보여주고, 필요한 메트릭과 감사 이벤트를 남깁니다.
Bedrock Runtime에는 목적이 다른 API가 있습니다. Converse는 메시지를 지원하는 모델들에 공통 대화 인터페이스를 제공하므로 모델 교체가 쉬운 편입니다. InvokeModel은 이미지·임베딩을 포함해 모델 고유 형식과 기능을 더 직접적으로 제어할 때 사용합니다. 최신 Bedrock은 OpenAI 호환 Responses·Chat Completions API와 Anthropic Messages API도 제공하지만, 엔드포인트와 모델마다 지원 기능이 같지는 않으므로 호환성 표를 확인해야 합니다. Bedrock 지원 API, Converse API
4. 어떤 모델을 사용할 수 있나
Bedrock은 하나의 “AWS LLM”이 아닙니다. 다양한 공급자와 용도의 파운데이션 모델을 담은 카탈로그입니다. 2026년 8월 기준 공식 가격표와 모델 카탈로그에는 Amazon, Anthropic, Meta, Mistral AI뿐 아니라 AI21 Labs, Cohere, DeepSeek, Google, Luma AI, MiniMax, Moonshot AI, NVIDIA, OpenAI, Qwen, Stability AI, TwelveLabs, Writer, xAI, Z.AI 등 여러 공급자가 포함됩니다. 모델과 리전은 계속 바뀌므로 이름을 하드코딩한 목록보다 공식 카탈로그와 API 조회 결과를 기준으로 삼아야 합니다. Bedrock 모델 카탈로그, Bedrock 가격표의 공급자 목록
실무에서는 회사 이름보다 입력과 출력의 종류로 나누는 편이 이해하기 쉽습니다.
Amazon 자체 모델만 보더라도 Nova 계열에는 비용과 지연시간에 초점을 둔 텍스트 모델, 멀티모달 이해, 이미지 생성, 영상 생성, 음성 대화, 임베딩 모델이 있습니다. 다른 공급자의 모델까지 더하면 선택지는 훨씬 넓어집니다.
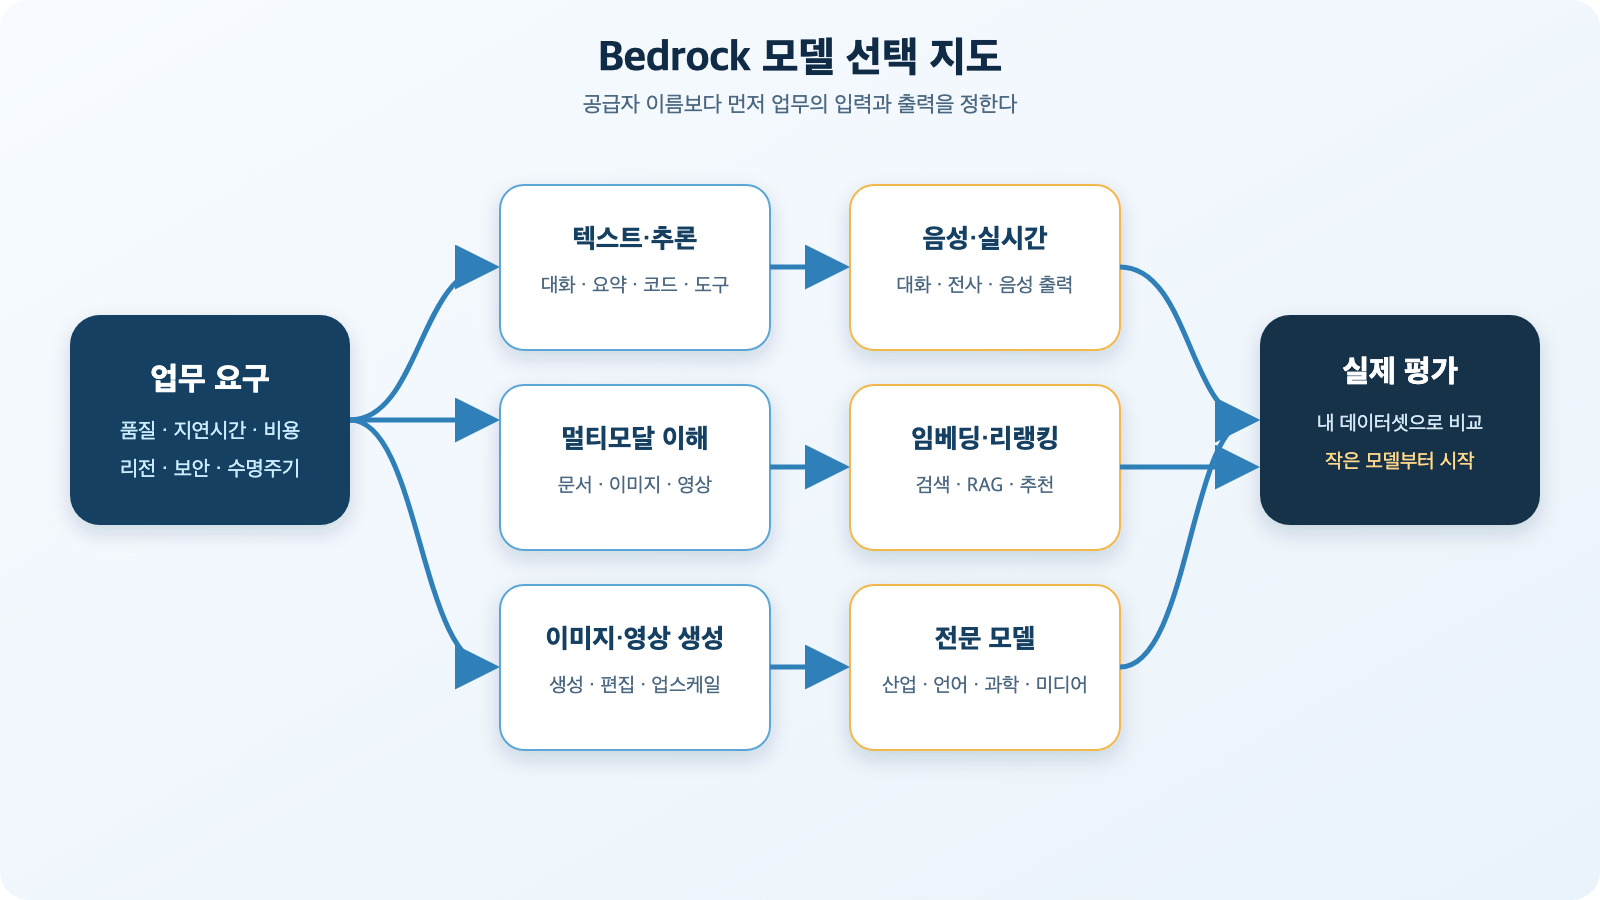
그림 2. 모델 공급자보다 먼저 입출력 형태와 업무 목적을 고른다. AWS Models at a glance를 바탕으로 재구성.
모델 선택은 벤치마크 1등 찾기가 아니다
가장 큰 모델이 항상 가장 좋은 선택은 아닙니다. 실제 데이터셋으로 다음 항목을 함께 측정해야 합니다.
- 품질: 정답률, 충실성, 도구 호출 성공률, 한국어 품질
- 지연시간: 첫 토큰 시간과 전체 응답 시간
- 비용: 입력·출력 토큰, 캐시, 가드레일, 검색 비용
- 컨텍스트: 필요한 문서 길이와 멀티모달 입력 지원
- 운영성: 필요한 리전, 온디맨드 여부, 할당량, 스트리밍 지원
- 수명주기: Active·Legacy·EOL 상태와 마이그레이션 계획
Bedrock 모델은 Active, Legacy, End-of-Life 상태로 관리됩니다. AWS 문서상 모델은 Bedrock에 출시된 뒤 EOL까지 최소 12개월을 두지만, Legacy가 되면 신규 사용 제한과 이전 계획이 필요할 수 있습니다. 운영 코드에서는 모델 ID를 설정으로 분리하고 회귀 평가를 자동화하는 편이 안전합니다. Bedrock 모델 수명주기
현재 계정과 리전에서 실제 사용 가능한 기본 모델은 CLI로 확인할 수 있습니다.
aws bedrock list-foundation-models \
  --region us-east-1 \
  --query 'modelSummaries[].{provider:providerName,name:modelName,id:modelId,status:modelLifecycle.status}' \
  --output table
이 결과가 블로그나 오래된 예제의 모델 목록보다 정확합니다. 같은 모델도 리전, 추론 방식, 기능 지원이 다를 수 있습니다. Bedrock 모델 조회 방법
5. Bedrock은 모델 주변의 무엇을 제공하나
Bedrock의 실무 가치는 모델 호출보다 주변 기능에서 커집니다.
Knowledge Bases: 사내 문서를 연결하는 관리형 RAG
RAG(Retrieval-Augmented Generation)는 질문과 관련된 사내 문서를 먼저 찾고, 그 내용을 모델 입력에 붙여 답변 근거를 보강하는 방법입니다. Knowledge Bases는 문서 수집, 분할, 임베딩 생성, 벡터 검색, 모델 호출을 연결해 줍니다.
이 기능은 RAG의 조립 부담을 줄이지만 자동으로 정확성을 보장하지는 않습니다. 청킹 방식, 메타데이터 필터, 임베딩과 리랭커, 접근 제어, 근거 평가를 실제 데이터로 검증해야 합니다.
Guardrails: 모델 바깥의 공통 안전 정책
Guardrails는 사용자 입력과 모델 응답을 검사합니다. 콘텐츠 필터, 금지 주제, 단어 필터, 민감정보, 이미지 필터 같은 정책을 조합할 수 있고, 모델 추론·Knowledge Bases·에이전트·Flow에 적용할 수 있습니다. 입력이 차단되면 모델 호출 자체가 수행되지 않을 수 있고, 출력이 정책을 위반하면 차단 메시지나 마스킹 결과로 교체됩니다. Bedrock Guardrails 동작 방식
가드레일은 보안 경계 전체를 대신하지 않습니다. IAM 권한, 도구별 승인, 데이터 접근 통제, 출력 검증, Human-in-the-Loop가 별도로 필요합니다.
Agents와 AgentCore: 모델이 도구를 사용하게 만들기
에이전트는 모델이 질문만 답하는 데서 끝나지 않고 API나 Lambda 같은 도구를 선택해 작업하도록 만듭니다. 기존 Agents for Amazon Bedrock은 작업 오케스트레이션을 관리형으로 제공하고, 최신 AWS 문서는 새 에이전트 애플리케이션의 배포·운영 플랫폼으로 AgentCore를 권장합니다. 둘은 모델 자체가 아니라 모델에게 메모리, 도구, 실행 환경, 관측성과 권한 경계를 붙이는 계층입니다. Bedrock Agents 모델 사용 안내
Model Evaluation과 커스터마이징
Bedrock Evaluation은 모델과 Knowledge Bases를 자동 지표, LLM 심사, 사람 평가로 비교할 수 있게 합니다. 모델 커스터마이징은 지원되는 모델과 리전에서 지도 미세조정, 강화 미세조정, 증류 같은 방법을 제공합니다. 증류는 큰 교사 모델의 응답을 이용해 더 작고 빠른 학생 모델을 특정 업무에 맞추는 방식입니다. Bedrock 평가, 모델 커스터마이징
6. 가장 작은 Python 호출 예제
먼저 애플리케이션이 사용하는 IAM 역할에 필요한 모델의 bedrock:InvokeModel 권한을 최소 범위로 부여합니다. 로컬에서는 AWS CLI 자격 증명이 이미 안전하게 구성돼 있다고 가정합니다. 액세스 키를 코드에 넣지 않습니다.
import boto3

client = boto3.client("bedrock-runtime", region_name="us-east-1")

response = client.converse(
    modelId="YOUR_MODEL_ID",
    messages=[
        {
            "role": "user",
            "content": [{"text": "Amazon Bedrock을 한 문장으로 설명해줘."}],
        }
    ],
    inferenceConfig={
        "maxTokens": 200,
        "temperature": 0.2,
    },
)

print(response["output"]["message"]["content"][0]["text"])
print(response["usage"])
YOUR_MODEL_ID는 앞의 list-foundation-models 결과나 공식 모델 카탈로그에서 현재 리전이 지원하는 값으로 바꿉니다. Converse는 공통 메시지 구조를 제공하지만, 모든 모델이 같은 모달리티·도구 호출·추론 파라미터를 지원한다는 뜻은 아닙니다.
7. 비용은 어떻게 계산할까
Bedrock에는 하나의 단일 요금이 없습니다. 모델, 공급자, 입출력 모달리티, 리전과 추론 방식에 따라 달라집니다.
온디맨드
텍스트 모델은 대체로 입력 토큰과 출력 토큰을 따로 계산합니다. 이미지·영상·음성 모델은 이미지 수, 해상도, 생성 시간 같은 다른 단위를 사용할 수 있습니다. 트래픽이 작거나 불규칙하고 여러 모델을 실험할 때 적합합니다.
배치
즉시 응답이 필요하지 않은 대량 작업에 사용합니다. AWS는 지원되는 일부 모델의 배치 추론을 온디맨드보다 50% 낮은 가격으로 안내합니다. 야간 문서 분류, 요약, 임베딩 생성처럼 지연을 허용하는 작업에 유리합니다. Bedrock 가격표
Provisioned Throughput와 서비스 티어
지속적이고 예측 가능한 처리량이 필요하면 Model Unit 단위의 Provisioned Throughput을 구매할 수 있습니다. 시간당 과금되며 약정 기간과 모델에 따라 비용이 달라집니다. 최신 가격표에는 Standard, Flex, Priority, Reserved 같은 서비스 티어도 있으므로 지연시간·비용·용량 보장 요구에 맞춰 확인해야 합니다.
모델 비용만 계산하면 실제 청구액을 놓치기 쉽습니다. Knowledge Bases의 임베딩·벡터 저장소, Guardrails 검사, 모델 평가, 로그 저장, Lambda와 데이터 전송 비용도 함께 봐야 합니다. 비용 태그와 Application Inference Profile, CloudWatch 지표를 이용해 팀과 서비스별 사용량을 분리하는 것이 좋습니다.
8. 보안과 운영에서 유용한 이유
Bedrock을 AWS 조직에서 선호하는 이유는 기존 통제 체계와 연결하기 쉽기 때문입니다.
- IAM으로 호출 주체와 허용 모델을 제한할 수 있습니다.
- CloudTrail로 API 활동을 감사하고 CloudWatch로 사용량과 운영 지표를 관찰할 수 있습니다.
- KMS 암호화와 VPC 엔드포인트를 조합해 데이터 경계를 강화할 수 있습니다.
- 모델별 권한, Knowledge Base 데이터, Guardrail 정책을 계정과 리전 단위로 분리할 수 있습니다.
Converse API 문서는 요청에 제공한 텍스트·이미지·문서를 Bedrock이 저장하지 않고 응답 생성에만 사용한다고 명시합니다. 다만 조직이 모델 호출 로깅을 켜거나 애플리케이션이 입력을 별도로 저장하면 그 데이터는 로그와 S3의 보존 정책을 따릅니다. “Bedrock이 저장하지 않는다”와 “우리 시스템 어디에도 남지 않는다”는 다른 말입니다. Converse API 데이터 처리 설명
또한 모델이 안전하다고 전체 애플리케이션이 안전한 것은 아닙니다. RAG 문서의 접근 권한, 에이전트 도구의 실행 권한, 프롬프트 인젝션, 과도한 로그, 개인정보, 사람이 승인해야 할 고위험 작업을 별도로 설계해야 합니다.
9. Bedrock, SageMaker AI, 직접 모델 API 중 무엇을 고를까
Bedrock은 “AI를 가장 깊게 제어하는 방법”이라기보다 “AWS 안에서 생성형 AI 애플리케이션을 가장 빨리 제품화하는 방법”에 가깝습니다. 반대로 특정 오픈 모델을 직접 수정하고 GPU 메모리, 배치 스케줄러, 추론 엔진까지 최적화해야 한다면 SageMaker AI나 자체 호스팅이 더 맞을 수 있습니다. AWS Bedrock 또는 SageMaker 결정 가이드
10. Bedrock이 특히 유용한 실제 사례
사내 문서 질의응답
S3 문서와 Knowledge Bases를 연결하고, Guardrails로 개인정보와 금지 주제를 통제하며, 답변에 검색 근거를 붙이는 형태입니다. 인프라를 처음부터 조립하지 않고 RAG의 핵심 부품을 빠르게 검증할 수 있습니다.
고객센터 요약과 상담 지원
긴 대화를 작은 모델로 분류·요약하고, 복잡한 질의만 더 강한 모델로 라우팅할 수 있습니다. PII 마스킹, 응답 근거, 사람 승인 단계를 함께 설계해야 합니다.
문서·이미지 자동 처리
멀티모달 모델로 계약서, 영수증, 도표와 제품 이미지를 이해하고 구조화된 결과를 생성할 수 있습니다. 생성 결과는 스키마 검증과 업무 규칙을 통과시킨 뒤 저장해야 합니다.
개발·보안 운영 보조
로그 요약, 티켓 분류, 코드 설명, 보안 이벤트 조사 초안을 만들 수 있습니다. 모델에게 운영 권한을 바로 주기보다 읽기 전용 도구부터 시작하고, 변경 작업에는 승인 게이트를 둡니다.
11. 도입 전에 반드시 확인할 한계
Bedrock은 편리하지만 다음 문제를 없애주지 않습니다.
- 모델마다 품질, 가격, 지연시간, 컨텍스트와 API 기능이 다릅니다.
- 원하는 모델이 모든 AWS 리전에 있지는 않습니다.
- 온디맨드에서도 할당량과 스로틀링이 있습니다.
- 모델 버전은 Legacy와 EOL로 이동하므로 회귀 평가와 교체 계획이 필요합니다.
- Guardrails는 위험을 줄이지만 모든 환각과 프롬프트 공격을 막지 못합니다.
- RAG는 문서를 연결할 뿐, 원본 데이터의 품질과 접근 권한을 자동으로 고쳐주지 않습니다.
- 서버리스는 운영 책임을 줄이지만 비용 예측과 애플리케이션 관측 책임까지 없애지는 않습니다.
12. 가장 현실적인 도입 순서
처음부터 에이전트와 미세조정까지 모두 켜기보다 작은 경로로 시작하는 편이 좋습니다.
- 업무 하나와 성공 지표를 정합니다. 예: 상담 요약 정확도 90%, 응답 3초 이내.
- 실제 데이터에서 개인정보를 제거한 평가 세트를 만듭니다.
- 작은 모델과 강한 모델 2~3개를 Converse API로 비교합니다.
- IAM 최소 권한, 예산 알림, CloudTrail과 필요한 메트릭을 먼저 설정합니다.
- 정확성에 사내 지식이 필요할 때 Knowledge Bases 또는 별도 RAG를 붙입니다.
- 입력·출력 정책이 필요할 때 Guardrails와 애플리케이션 검증을 추가합니다.
- 읽기 전용 도구에서 에이전트를 시작하고, 변경 작업에는 사람 승인을 둡니다.
- 트래픽이 안정된 뒤 배치, 캐시, 작은 모델, Provisioned Throughput을 비교해 비용을 최적화합니다.
결론: Bedrock의 핵심은 GPU가 아니라 운영 경계를 바꾸는 것
Amazon Bedrock의 가장 큰 장점은 생성형 AI가 GPU에서 실행된다는 사실을 감추는 데 있지 않습니다. 애플리케이션 팀이 GPU 확보, 드라이버, 모델 서버, 확장과 패치 대신 모델 선택, 데이터 품질, 권한, 안전성, 비용과 사용자 경험에 집중하게 만드는 데 있습니다.
여러 공급자의 텍스트·멀티모달·이미지·음성·임베딩 모델을 하나의 AWS 운영 체계에서 평가하고, Knowledge Bases·Guardrails·평가·에이전트 기능을 조합할 수 있다는 점도 강력합니다. 반면 낮은 수준의 GPU와 런타임 제어, 특정 모델의 최신 고유 기능, 아주 높은 고정 사용량의 비용 최적화가 우선이라면 SageMaker AI나 직접 호스팅도 함께 비교해야 합니다.
한 문장으로 정리하면 이렇습니다. Bedrock은 GPU를 사용하지 않는 서비스가 아니라, 사용자가 GPU를 운영하지 않고도 생성형 AI를 제품에 넣게 해주는 AWS의 관리형 모델 플랫폼입니다.
공식 참고 자료
'클라우드' 카테고리의 다른 글
| GPU 서버를 살까, AWS g6.xlarge를 빌릴까? LLM 보안 실습 비용 계산 (0) | 2026.08.21 |
|---|---|
| 클라우드 시대에도 TPS, CPU, Memory, IOPS 산정은 필요한가? (0) | 2026.07.07 |
| CloudWatch 로그 비용이 부담될 때, OpenSearch를 직접 구성하는 선택은 맞을까? (0) | 2026.06.20 |
| AWS Client VPN으로 VPC에 안전하게 접속하기 (0) | 2026.06.14 |
| Bastion Host를 대체하는 AWS Systems Manager Session Manager (0) | 2026.06.14 |


