🕸️ Cilium이 쿠버네티스 네트워크 계를 평정한 이유 — eBPF가 바꾼 패러다임의 역사
by gasbugs2026. 3. 31.
iptables는 세상을 바꾸는 스케일을 감당하지 못했다. eBPF는 커널 자체를 바꿨다.
🎯 이 글에서 다루는 것
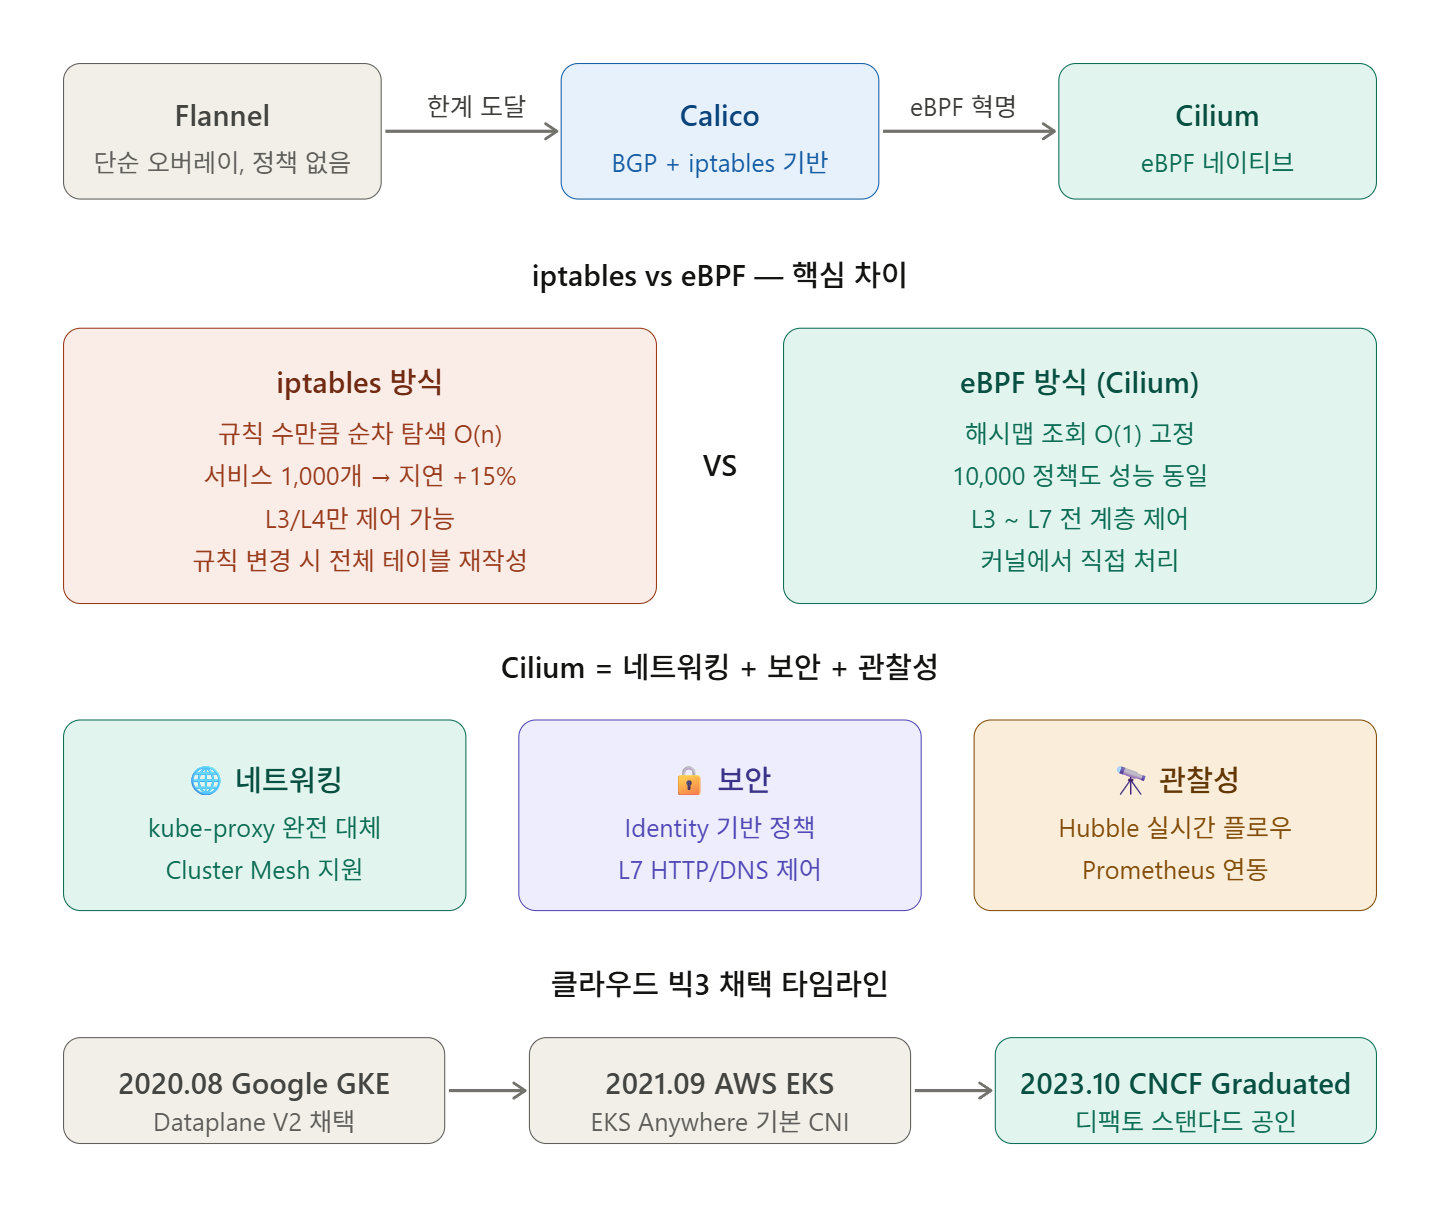
쿠버네티스 CNI의 역사: Flannel → Calico → Cilium으로 이어진 세대교체
iptables의 근본적 한계와 eBPF가 이를 어떻게 극복했는가
Google, AWS, Azure, Alibaba가 Cilium을 선택한 실제 이유
Cilium이 단순 CNI를 넘어 "네트워킹 플랫폼"이 된 과정
2026년 현재 디팩토 스탠다드가 된 결정적 증거들
📌 도입 — "CNI가 대체 뭐가 그렇게 중요해?"
쿠버네티스를 처음 배울 때 CNI(Container Network Interface)는 "그냥 설치하는 것"쯤으로 느껴진다.
kubectl apply -f flannel.yml 한 줄이면 파드끼리 통신이 된다.
그런데 클러스터 규모가 수백 노드, 수천 개 서비스로 커지면 현실이 달라진다. 네트워크 지연이 이상하게 늘어나고, 정책 변경이 느려지고, 디버깅을 할 수가 없다. 이 시점에서 운영팀은 공통된 결론에 도달한다.
CNI를 잘못 골랐다.
이것이 수많은 기업이 Flannel에서 Calico로, 그리고 Cilium으로 이전한 이유다. 그리고 지금 Cilium은 2025 CNCF State of Kubernetes Networking 보고서 기준 CNI 배포의 60% 이상을 차지하는 디팩토 스탠다드가 됐다. 어떻게 여기까지 왔을까?
🔍 1세대 CNI의 시대 — Flannel과 Calico
Flannel: "일단 연결만 되면 돼"
초기 쿠버네티스 플랫폼을 구축할 때 Flannel은 자연스러운 선택이었다. 가장 성숙하고, 의존성이 적었으며, 설치가 간단했고, 벤치마크에서도 높은 성능을 보였다.
Flannel의 철학은 단순했다. VXLAN 오버레이로 모든 파드가 서로 통신할 수 있는 평탄한 네트워크를 만들어라. 그뿐이다.
네트워크 정책? 없다.
관찰성? 없다.
보안? 직접 알아서.
소규모 클러스터에서는 충분했다. 하지만 트래픽이 늘어나자 iptables와 netfilter의 한계가 드러나기 시작했다.
Calico: "BGP로 진지하게 가보자"
Calico는 인터넷 백본을 구동하는 것과 동일한 프로토콜인 BGP를 라우팅에 사용했고, 2016년부터 엔터프라이즈의 기본 선택지가 됐다.
Calico는 네트워크 정책도 지원했다. 보안팀이 원하는 L3/L4 수준의 트래픽 제어가 가능해졌다. 그런데 문제가 있었다.
iptables는 선형(linear)으로 동작한다.
iptables 방식에서는 정책이 늘어날수록 규칙을 순차적으로 평가하기 때문에, 정책 1,000개 환경에서는 10~15%의 레이턴시 오버헤드가 발생할 수 있다.
서비스가 수백 개를 넘어가면 iptables 규칙 테이블이 수만 줄로 불어난다. 규칙 변경 시 전체 테이블을 다시 써야 하고, 이 과정에서 일시적인 트래픽 단절이 발생한다. 대규모 클러스터에서 이건 재앙이다.
🔍 Cilium의 등장 — eBPF라는 도박
2015~2016: "커널을 바꿔버리자"
Cilium은 2015년 12월 나중에 Isovalent를 창립하는 개발자들에 의해 탄생했고, 2016년 LinuxCon에서 eBPF와 XDP를 활용한 빠른 IPv6 컨테이너 네트워킹 프로젝트로 처음 공개됐다.
당시엔 도박이었다. 대부분의 CNI가 iptables 위에서 동작하는 것이 상식이었는데, Cilium은 처음부터 eBPF에 올인했다. Cilium은 eBPF가 클라우드 네이티브 네트워킹의 미래가 될 것이라고 베팅하며, 처음부터 eBPF 기반 데이터플레인을 구축했다.
eBPF란 무엇인가?
eBPF(extended Berkeley Packet Filter)를 쉽게 설명하면 이렇다.
기존에 커널 기능을 바꾸려면 커널 소스를 수정하고 재컴파일해야 했다. 수개월이 걸리는 작업이다. eBPF는 커널을 고치지 않고, 커널 안에 코드를 안전하게 주입하는 기술이다. 네트워크 패킷이 커널을 통과하는 바로 그 지점에서 내가 원하는 로직을 실행할 수 있다.
eBPF는 커널 안에서 동작하기 때문에 유저 스페이스와 커널 스페이스 사이의 비싼 컨텍스트 스위칭을 피할 수 있고, 결과적으로 레이턴시, 처리량, 성능 효율이 대폭 향상된다.
2018~2020: 본격적인 검증
2018년 4월 Cilium 1.0이 첫 안정 버전으로 출시됐고, 2019년 11월에는 eBPF 기반 네트워크 관찰성을 제공하는 Hubble이 런칭됐다.
그리고 결정적인 사건이 일어났다.
2020년 8월, Google이 GKE의 새 데이터플레인으로 Cilium을 선택했다.
Google Cloud는 Cilium을 채택해 GKE Dataplane V2를 만들었으며, eBPF를 활용해 kube-proxy의 iptables 기반 서비스 라우팅 같은 전통적인 커널 네트워킹 경로를 우회함으로써 고효율 패킷 처리를 구현했다.
Google이 선택했다는 것은 업계 전체에 강력한 신호였다.
🔍 왜 클라우드 빅3가 모두 Cilium을 선택했나
Google GKE
2024년 GKE는 최대 65,000 노드 클러스터를 지원한다고 발표했는데, 이 엄청난 확장성은 상당 부분 GKE Dataplane V2의 견고하고 최적화된 아키텍처 덕분에 가능했다. GKE Dataplane V2는 Cilium 기반이다.
AWS EKS Anywhere
2021년 9월 AWS는 EKS Anywhere의 네트워킹과 보안을 위해 Cilium을 선택했다.
Alibaba Cloud ACK
Alibaba는 기존 veth 기반 컨테이너 네트워킹 모델에서 네임스페이스 간 패킷 전환 시 상당한 오버헤드가 발생하고, 기본 iptables 기반 서비스 모드에서 규칙 증가에 따른 높은 비용 문제를 인식했다. Cilium을 통해 이 두 가지 핵심 문제를 해결할 수 있었다.
세계 3대 클라우드 사업자가 모두 같은 결론에 도달했다. iptables는 한계에 왔고, eBPF만이 답이었다.
🔍 Cilium이 단순 CNI를 넘어선 이유
Cilium을 단순히 "빠른 CNI"로 보면 안 된다. Cilium은 세 가지 영역을 하나로 통합했다.
1️⃣ 네트워킹 — kube-proxy 완전 대체
Cilium은 eBPF의 효율적인 해시테이블을 사용해 kube-proxy를 완전히 대체하며, 소켓 레벨에서 서비스 연결을 재작성해 패킷별 NAT 오버헤드를 없앤다.
kube-proxy가 없으면? iptables 규칙 폭발이 사라진다. 10,000개의 네트워크 정책이 있는 클러스터와 10개가 있는 클러스터의 성능이 동일하다. O(1) 해시맵 조회이기 때문이다.
2️⃣ 보안 — IP가 아닌 Identity 기반
기존 CNI는 IP 주소 기반으로 정책을 적용한다. 문제는 파드의 IP가 수시로 바뀐다는 것. Cilium은 쿠버네티스 레이블을 Identity로 삼아 정책을 적용한다.
더 나아가 Cilium은 L7 정책을 지원한다.
# HTTP Method, Path까지 제어하는 L7 정책 예시
apiVersion: cilium.io/v2
kind: CiliumNetworkPolicy
metadata:
  name: api-http-policy
  namespace: production
spec:
  endpointSelector:
    matchLabels:
      app: backend-api
  ingress:
  - fromEndpoints:
    - matchLabels:
        app: frontend
    toPorts:
    - ports:
      - port: "8080"
        protocol: TCP
      rules:
        http:
        - method: GET
          path: "/api/.*"    # GET /api/* 만 허용
        - method: POST
          path: "/api/data"  # POST /api/data 만 허용
        # 그 외 모든 요청은 차단
기존 iptables로는 불가능한 L7 수준 제어다. 서비스메시 없이 이게 가능하다.
3️⃣ 관찰성 — Hubble
네트워크 문제 디버깅의 지옥을 경험해 봤다면 Hubble이 얼마나 강력한지 알 것이다.
Hubble은 개별 네트워크 패킷 플로우를 관찰하고, 트래픽 허용/차단에 대한 네트워크 정책 결정을 확인하며, 쿠버네티스 서비스가 어떻게 통신하는지 서비스 맵으로 보여준다. 이 데이터는 Prometheus, OpenTelemetry, Grafana로 내보낼 수 있다.
iptables로 트래픽이 왜 막혔는지 추적하던 시절과 비교하면 세상이 달라졌다.
💻 Cilium 설치 및 기본 확인
# Cilium CLI 설치
curl -L --remote-name-all \
  https://github.com/cilium/cilium-cli/releases/latest/download/cilium-linux-amd64.tar.gz
tar xzvf cilium-linux-amd64.tar.gz
sudo mv cilium /usr/local/bin/

# 클러스터에 Cilium 설치 (kube-proxy 대체 포함)
cilium install \
  --set kubeProxyReplacement=true \
  --set hubble.relay.enabled=true \
  --set hubble.ui.enabled=true

# 설치 상태 확인
cilium status

# kube-proxy 대체 여부 확인
kubectl exec -n kube-system ds/cilium -- cilium status | grep KubeProxyReplacement
# KubeProxyReplacement: True

# Hubble로 실시간 트래픽 관찰
hubble observe --follow --namespace production
⚠️ 주의사항 / 흔한 실수
커널 버전 확인 필수
Cilium 설치는 Linux 커널 5.10 이상(또는 RHEL 8.10 기준 4.18 이상)을 요구하며, eBPF 지원이 커널 설정에서 활성화되어 있어야 한다. 구버전 OS에서 Cilium을 올리면 조용히 기능이 비활성화된다.
메모리 오버헤드 계획
Cilium 에이전트는 엔드포인트와 정책 수에 따라 노드당 150~250MB의 메모리를 소비한다. 100노드 클러스터라면 최소 15~25GB의 추가 메모리를 예상해야 한다. 대신 Cilium의 처리량 향상으로 전체 노드 수를 10~15% 줄일 수 있다는 운영 사례가 있다.
소규모 클러스터에서의 가성비
200노드 미만, 500개 서비스 이하의 클러스터에서는 두 CNI 모두 충분히 잘 동작하며 성능 차이가 결정적인 요소가 되지 않는다. 학습 환경이라면 Flannel로 시작하는 것도 나쁘지 않다.
✅ 정리 — 왜 Cilium이 표준이 됐는가
Cilium의 부상은 단순히 "더 빠른 CNI"가 나왔기 때문이 아니다. 근본적인 아키텍처 전환이었다.
구분
기존 방식 (iptables)
Cilium (eBPF)
성능 특성
규칙 수에 비례해 선형 저하
규칙 수와 무관한 O(1)
정책 레이어
L3/L4
L3 ~ L7
kube-proxy
별도 컴포넌트 필요
eBPF로 완전 대체
관찰성
tcpdump, 로그 파일
Hubble (실시간 플로우)
서비스메시
사이드카 필요
사이드카 없이 가능
2023년 10월 CNCF Graduated 프로젝트로 졸업했으며, 21,000개 이상의 GitHub 스타와 900명 이상의 컨트리뷰터를 보유한 커뮤니티가 그 어떤 CNI보다 빠르게 성장하고 있다.
eBPF 네이티브 특성은 나중에 추가된 기능이 아니라 아키텍처의 근본이며, 성능과 관찰성의 특성이 애드온이 아닌 설계 자체에서 나온다.
다음 단계로는 Hubble UI를 통한 서비스 맵 탐색, CiliumNetworkPolicy로 L7 정책 실습, Tetragon을 활용한 런타임 보안 탐색을 권장한다.